
Inhalt
- 1. Ausgangslage: Wissensarbeit braucht KI, sensible Daten brauchen Grenzen
- 2. Grundidee und Leitprinzipien
- 3. Schutzklassen als Leitregel
- 4. Modellstufen und Routing: welches Modell welche Daten sieht
- 5. Erfassung: Aus Eingängen wird geprüftes Wissen
- 6. Antworten aus dem eigenen Bestand
- 7. Fachkollegium: spezialisierte Agenten mit Mandat
- 8. Werkstatt und Wissensräume: vom Wissen zum Ergebnis
- 9. Kontrolle und Nachweis
- 10. Betrieb: Infrastruktur, Leistung und Kosten
- 11. Bewertung: Optionen, Risiken, Gegenargumente
- 12. Handlungscheckliste
Management Summary
Sprachmodelle beschleunigen Recherche, Auswertung und Textproduktion erheblich. Die ergiebigsten Unterlagen der Wissensarbeit enthalten jedoch personenbezogene und vertrauliche Daten, deren Weitergabe an Dritte die Datenschutz-Grundverordnung eng begrenzt [1]. Das Second Brain löst diesen Zielkonflikt über seine Architektur: Jedes Objekt erhält bei der Erfassung eine von drei Schutzklassen, und ein zentrales Modell-Gateway lässt Inhalte nur zu der Modellstufe durch, die ihre Klasse erlaubt. Vertrauliches verarbeitet ausschließlich ein lokales Sprachmodell, Persönliches verlässt die eigene Infrastruktur nur pseudonymisiert, Öffentliches darf leistungsstarke Cloud-Modelle nutzen. Antworten stützen sich auf den eigenen Bestand, tragen Belege und werden automatisch geprüft. Der Preis dieser Souveränität liegt in lokaler Rechenleistung und einer konsequenten Prüfdisziplin.
Für wen relevant?
Geschäftsführungen und Inhaber wissensintensiver Unternehmen; CIO und CISO; Datenschutzbeauftragte; IT-Architektinnen und IT-Architekten, die KI-Plattformen planen; Kanzleien, Beratungen, Arztpraxen und Forschungseinrichtungen mit vertraulichen Mandats-, Patienten- oder Projektdaten; Wissensarbeitende, die einen persönlichen Wissensspeicher mit KI aufbauen.
Drei Kernaussagen
- Die Schutzklasse eines Inhalts bestimmt das Sprachmodell, nicht die Entscheidung des Nutzers im Einzelfall. Die Datenschutz-Grundverordnung sieht für Verstöße gegen die Verarbeitungsgrundsätze Bußgelder bis zu 20 Mio. EUR oder 4 % des weltweiten Jahresumsatzes vor [1], und pseudonymisierte Daten bleiben personenbezogene Daten [2]. Ein Gateway, das bei jedem Aufruf die höchste beteiligte Klasse durchsetzt, macht diese Rechtslage technisch wirksam.
- Für vertrauliche Inhalte ist ein lokales Sprachmodell die Voraussetzung und keine Notlösung. Beschäftigte von Samsung gaben 2023 nach Medienberichten innerhalb eines Monats dreimal vertrauliche Informationen in ChatGPT ein [3], und 2026 betrafen nach Messungen eines Sicherheitsanbieters 39,7 % der Datenbewegungen in KI-Werkzeuge sensible Daten [4]. Organisatorische Regeln allein verhindern solche Abflüsse nicht zuverlässig.
- Belegte Antworten aus dem eigenen Bestand sind prüfbar, freie Modellantworten sind es nicht. Retrieval-gestützte Generierung übertraf bei ihrer Einführung rein parametrische Modelle in drei Aufgaben der offenen Fragebeantwortung [5]. Die automatische Messung der Belegtreue stimmte in der Originalstudie zu 95 % mit menschlichen Urteilen überein und macht die Qualität jeder Antwort messbar [6].
1. Ausgangslage: Wissensarbeit braucht KI, sensible Daten brauchen Grenzen
Der Begriff Second Brain bezeichnet ein externes, zentrales und digitales Archiv für das, was eine Person lernt, und für die Quellen dieses Wissens [7]. Tiago Forte hat den Begriff mit einem Buch und einer Methode aus vier Schritten bekannt gemacht: Erfassen, Ordnen, Verdichten und Ausdrücken [8]. In dieser ursprünglichen Form beruht ein Second Brain auf Notizwerkzeugen und auf der Disziplin seiner Nutzer. Sprachmodelle erweitern die Idee grundlegend, weil sie den Bestand nicht nur speichern, sondern befragen, auswerten und in neue Texte überführen. Das hier beschriebene Konzept versteht das Second Brain deshalb als Verbindung aus einem geordneten Wissensbestand und einer KI, die mit diesem Bestand arbeitet.
Der Nutzen einer solchen Verbindung steigt mit der Qualität der Inhalte, und an dieser Stelle entsteht der Konflikt. Die ergiebigsten Unterlagen von Wissensarbeitenden sind selten öffentlich: Verträge, Korrespondenz mit Dritten, Finanzunterlagen, Gesundheitsinformationen, Projektakten mit Namen und Konditionen. Die Datenschutz-Grundverordnung verlangt für personenbezogene Daten Zweckbindung, Datenminimierung und Vertraulichkeit und untersagt die Verarbeitung besonderer Kategorien wie Gesundheitsdaten grundsätzlich, sofern keine der eng gefassten Ausnahmen greift [1]. Ausgenommen sind nur ausschließlich persönliche oder familiäre Tätigkeiten; sobald ein Second Brain beruflich genutzt wird, gelten die Pflichten der Verordnung in vollem Umfang [1]. Wer solche Inhalte in einen beliebigen Cloud-Dienst kopiert, verlässt diesen Rahmen häufig, ohne es zu bemerken.
Dass dieses Risiko praktische Folgen hat, belegen dokumentierte Fälle. Im Frühjahr 2023 gaben Beschäftigte von Samsung nach Medienberichten innerhalb von weniger als einem Monat dreimal vertrauliche Informationen in ChatGPT ein, darunter Quellcode, Testsequenzen für Chips und Besprechungsnotizen [3]. Das Unternehmen untersagte daraufhin vorübergehend die Nutzung generativer KI auf Firmengeräten und in internen Netzen und begründete dies unter anderem damit, dass sich Daten auf externen Servern nur schwer zurückholen und löschen lassen [9]. Ein Anbieter von Datensicherheitssoftware wertete für seinen Bericht 2026 Datenbewegungen in 222 Unternehmen aus: 39,7 % der Datenbewegungen in KI-Werkzeuge betrafen sensible Daten, und Beschäftigte gaben im Durchschnitt alle drei Tage sensible Daten in ein solches Werkzeug ein [4]. In einer weltweiten Befragung von 48.340 Personen in 47 Ländern gab fast die Hälfte der Beschäftigten an, sensible Unternehmensinformationen oder urheberrechtlich geschütztes Material in öffentliche KI-Werkzeuge hochgeladen zu haben [10]. Verbote und Schulungen senken dieses Risiko, beseitigen es aber nicht, weil sie auf die Aufmerksamkeit jedes Einzelnen im Arbeitsalltag angewiesen sind.
Die naheliegende Gegenbewegung, KI von sensiblen Inhalten ganz fernzuhalten, hat ebenfalls einen Preis: Gerade die vertraulichen Bestände enthalten das Wissen, dessen Auswertung am meisten Zeit spart. Das Konzept setzt deshalb an der Architektur an. Nicht der Nutzer entscheidet im Einzelfall, welches Modell welche Daten sieht, sondern eine Regel, die das System bei jeder Verarbeitung durchsetzt und deren Einhaltung es selbst nachweist. Für vertrauliche Inhalte folgt daraus ein Sprachmodell auf eigener Infrastruktur. Der Leitgedanke lässt sich so zusammenfassen: Nicht die Daten gehen zur KI, sondern die KI kommt zu den Daten.
2. Grundidee und Leitprinzipien
Das Second Brain gliedert sich in vier Funktionsbereiche, die Abbildung 1 zeigt. Die Erfassung nimmt Dokumente, Weblinks, E-Mails, Sprachnotizen und eigene Notizen entgegen und bereitet sie auf. Der Bestand hält jedes Objekt als Datei mit Metadaten und stellt einen Suchindex sowie ein Objektverzeichnis bereit. Die Nutzung umfasst Fragen an den Bestand, spezialisierte Fachagenten, eine Werkstatt für Arbeitsergebnisse und thematische Wissensräume. Die Kontrolle prüft laufend, ob das System seine Regeln einhält.
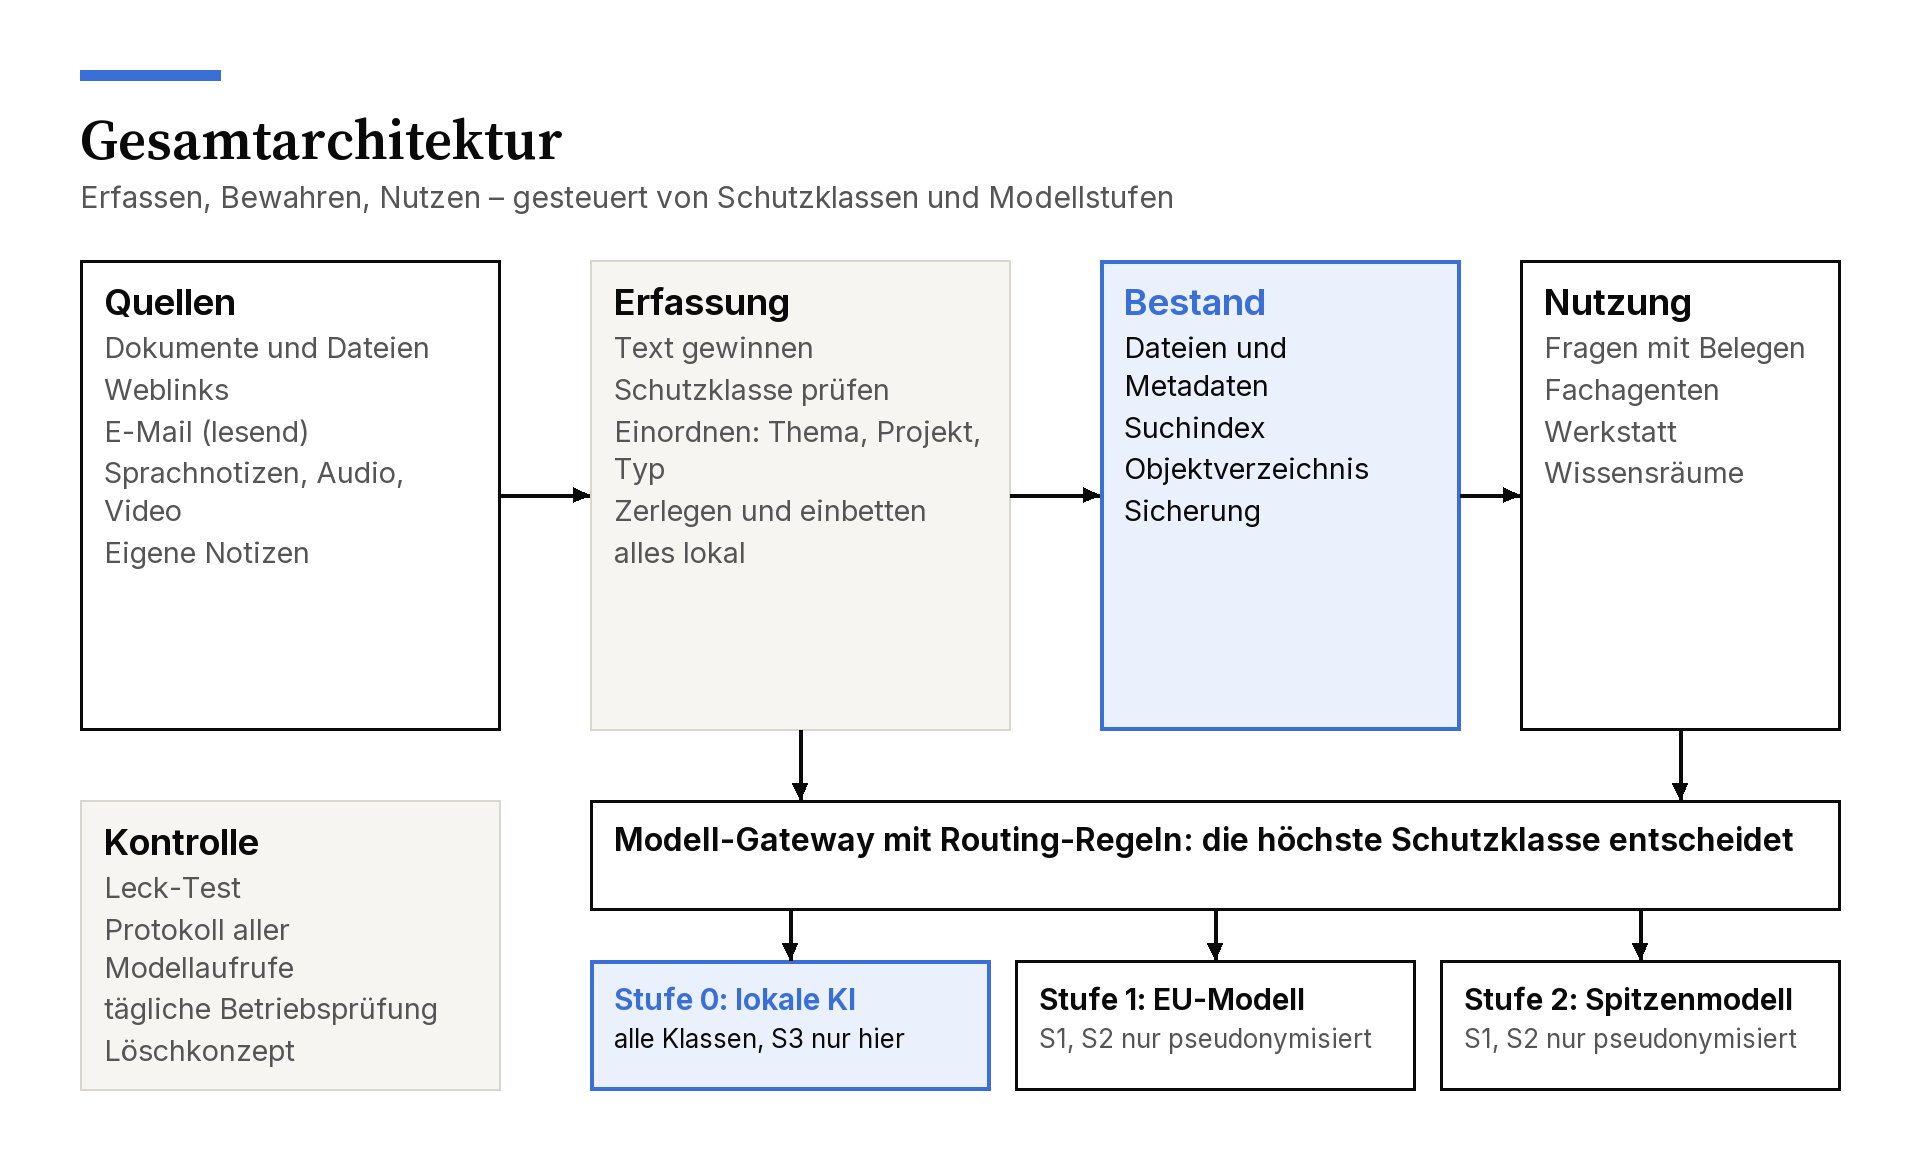
Alle Verbindungen zu Sprachmodellen laufen über ein zentrales Modell-Gateway. Es kennt drei Modellstufen: Stufe 0 ist ein lokales Sprachmodell auf eigener Infrastruktur, Stufe 1 das Modell eines Anbieters mit Sitz und Rechenzentren in der Europäischen Union, Stufe 2 ein leistungsstarkes Spitzenmodell eines internationalen Anbieters. Welche Stufe eine Verarbeitung nutzen darf, ergibt sich aus der Schutzklasse der beteiligten Inhalte. Das Gateway ist damit die einzige Stelle, an der Daten die eigene Infrastruktur in Richtung eines Modellanbieters verlassen können, und zugleich die Stelle, an der sich die Regel überwachen lässt.
Sieben Leitprinzipien bestimmen das Konzept:
- Bestand als Quelle der Wahrheit: Maßgeblich sind die Dateien in offenen Formaten. Suchindex und Verzeichnisse sind abgeleitet und lassen sich innerhalb eines Tages vollständig aus dem Bestand neu aufbauen.
- Dreistufiges Routing: Zwischen lokaler Verarbeitung und internationalem Spitzenmodell steht eine europäische Stufe. Persönliche Inhalte lassen sich damit pseudonymisiert und in guter Qualität verarbeiten, ohne den europäischen Rechtsraum zu verlassen.
- Freigabe vor Autonomie: Handlungen mit Außenwirkung, Übernahmen in den Fachkorpus und neue Fachagenten setzen eine Bestätigung des Nutzers voraus.
- Lernen ohne Training: Das System verbessert sich über Verfahrensbeschreibungen, Lernnotizen und ein Journal, nicht über veränderte Modellgewichte. Jede Verbesserung bleibt lesbar und lässt sich zurücknehmen.
- Föderierte Quellen statt Datenkopien: Externe Ablagen und Dokumentenarchive fragt das System über Konnektoren ab, statt sie vollständig zu kopieren.
- Verifikation statt Vertrauen: Ein Antwortvertrag, eine automatische Belegprüfung und Evaluationssets machen die Qualität messbar. Eine Enthaltung ohne Grundlage im Bestand gilt als erwünschtes Ergebnis und nicht als Fehler.
- Austauschbarkeit jeder Komponente: Für jede Komponente sind eine Alternative und ein Ausstiegspfad benannt. Der Wechsel eines Modellanbieters ist eine Änderung der Konfiguration, nicht des Programmcodes.
Der Bestand selbst ist bewusst schlicht gehalten. Jedes Objekt besteht aus dem Original, einer Textfassung im Format Markdown und einer lesbaren Metadatendatei mit Titel, Quelle, Datum, Prüfsumme, Themen und Schutzklasse. Die Hauptkopie liegt getrennt von der Verarbeitung in einem Speicherdienst. Der Server, der die Dienste betreibt, arbeitet mit einer Arbeitskopie, die ein Abgleich alle fünf Minuten aktuell hält. Eigene Notizen und Arbeitsstände werden in beide Richtungen abgeglichen und lassen sich mit gewöhnlichen Notizwerkzeugen (etwa Obsidian) bearbeiten. Für den vertraulichen Bereich empfiehlt das Konzept zusätzlich eine Verschlüsselung auf Seite des Nutzers. Dieselben Bauprinzipien, Dateien als maßgebliche Quelle, eine mit Obsidian kompatible Ablage und eine Abstraktionsschicht über mehrere Modellanbieter einschließlich lokaler Modelle, beschreibt der Verfasser für die Plattform hekima.one in Architektur schlägt Hype.
Diese Prinzipien setzen den Grundsatz des Datenschutzes durch Technikgestaltung um, den Art. 25 der Datenschutz-Grundverordnung verlangt [1]. Sie verlagern den Schutz von der Aufmerksamkeit des Einzelnen in die Architektur, und das Konzept beschreibt sein Ziel entsprechend als Gedächtnis mit nachweisbaren Grenzen. Die Kehrseite behandeln die Abschnitte 10 und 11: Die lokale Modellstufe muss leistungsfähig genug sein, um die vertraulichen Aufgaben tatsächlich zu übernehmen.
3. Schutzklassen als Leitregel
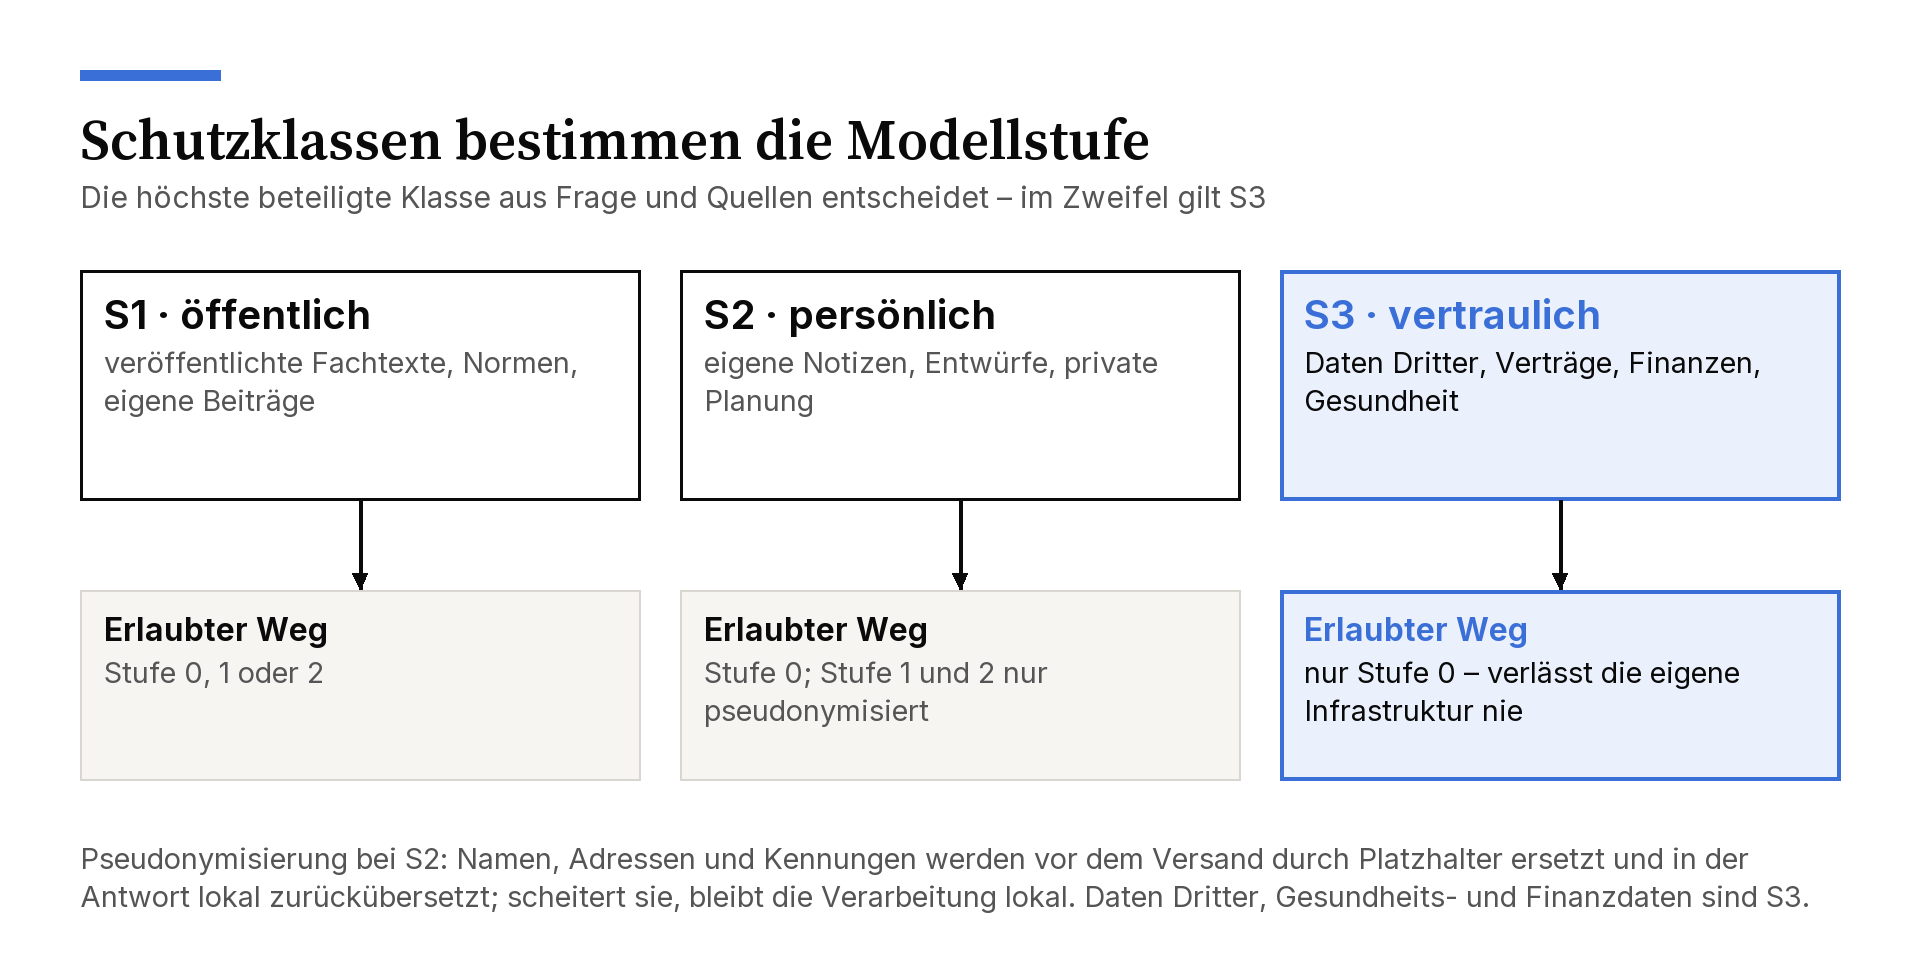
Die Schutzklasse ist das zentrale Steuerattribut des Second Brain. Sie wird bei der Erfassung vergeben, begleitet jeden Textabschnitt im Suchindex und begrenzt die höchste zulässige Modellstufe. Das Konzept unterscheidet drei Klassen. S1 umfasst öffentliche oder unkritische Inhalte, etwa Fachartikel, Normen, Fachliteratur und veröffentlichte Beiträge. S2 umfasst private Inhalte des Nutzers ohne Bezug zu Dritten, etwa eigene Notizen, eigene Entwürfe und Planungen. S3 umfasst personenbezogene Daten Dritter, geschäftliche oder vertrauliche Unterlagen sowie Gesundheits- und Finanzdaten, also Kundenunterlagen, Verträge, Korrespondenz und Projektdokumente. Abbildung 2 zeigt, welche Modellstufen jede Klasse erreichen darf.
Die Grenze zwischen S2 und S3 zieht das Konzept bewusst weit. Private und berufliche Inhalte gehen in der Wissensarbeit fließend ineinander über, und fast jede Korrespondenz enthält Daten anderer Personen. Geschäftliche Inhalte und Daten Dritter gelten deshalb stets als S3 und bleiben lokal. Diese Festlegung verzichtet auf einen Teil der Modellqualität, vermeidet aber Einzelfallabwägungen, die im Arbeitsalltag kaum jemand zuverlässig trifft.
Die Einstufung geschieht bei der Erfassung und ausschließlich lokal. Zuerst prüft eine Regel den gesamten Text auf Signalwörter und Muster, die auf S3 hinweisen, etwa Diagnosen, Kontonummern oder Vertragsbegriffe. Danach bewertet ein lokales Sprachmodell Anfang, Mitte und Ende des Dokuments. Es gilt die höchste der ermittelten Klassen, und ein Fehler des Modells zählt als S3. Das Modell kann einen Inhalt nie auf S1 herabstufen; Herabstufungen nimmt ausschließlich der Nutzer vor. Unklare Einstufungen und alle S3-Objekte gelangen in eine Freigabe-Warteschlange, in der der Nutzer die Klasse mit einem Klick bestätigt. E-Mails durchlaufen diese Warteschlange nicht, weil ihre Klasse per Regel feststeht.
Alle Voreinstellungen sind restriktiv. Ein nicht eingestuftes Objekt gilt als potenziell S3, eine unbekannte Klasse als S3, und ein Fachagent ohne gültigen Steckbrief erhält nur die lokale Stufe, kein Werkzeug und keinen Zugriff auf den Bestand. Externe Quellen und Postfächer sind ohne abweichende Festlegung S3.
Für jede Verarbeitung gilt die höchste beteiligte Klasse. Stellt der Nutzer eine Frage, die für sich genommen S2 wäre, und findet die Suche dazu ein S3-Dokument, wird die gesamte Verarbeitung als S3 behandelt. Diese Regel verhindert, dass vertrauliche Inhalte über den Umweg einer unverfänglichen Frage oder eines Zwischenergebnisses nach außen gelangen. Sie gilt auch für abgeleitete Ergebnisse: Ein Bericht, der aus S3-Quellen entsteht, erbt deren Klasse, und die Klasse eines Arbeitsstands kann steigen, aber nicht sinken.
Die Schutzklassen setzen die Grundsätze der Datenminimierung und der Vertraulichkeit aus Art. 5 der Datenschutz-Grundverordnung operativ um, und die restriktiven Voreinstellungen entsprechen der Forderung nach datenschutzfreundlichen Voreinstellungen aus Art. 25 Abs. 2 [1]. Sie ersetzen keine rechtliche Prüfung im Einzelfall, schaffen aber eine Voreinstellung, die im Zweifel schützt. Nach Einschätzung des Verfassers liegt gerade in dieser Voreinstellung der entscheidende Unterschied zu Werkzeugen, die die Entscheidung über den Datenfluss bei jedem Aufruf dem Nutzer überlassen.
4. Modellstufen und Routing: welches Modell welche Daten sieht
Stufe 0 verarbeitet Inhalte aller Klassen, weil ihre Daten die eigene Infrastruktur nicht verlassen. Als eigene Infrastruktur gilt der selbst administrierte Server mit einer lokalen Modelllaufzeit (etwa Ollama). Ein zusätzlich gemieteter Server mit Grafikprozessor zählt ebenfalls dazu, wenn der Betreiber ihn selbst einrichtet, er in der Europäischen Union steht, nur über einen verschlüsselten Tunnel erreichbar ist und nach einem Auftrag außer dem Modell keine Daten behält. Anbieter außerhalb der Europäischen Union schließt das Konzept für diese Rolle aus. Auch der gemietete Rechner bleibt eine Auftragsverarbeitung, für die ein Vertrag nach Art. 28 der Datenschutz-Grundverordnung erforderlich ist [1]. Ein Bericht aus dem Expertenpool des Europäischen Datenschutzausschusses beschreibt die Abwägung hinter dieser Stufe: Ein selbst betriebenes Modell gibt volle Kontrolle über die Daten, verlangt aber erhebliche Rechenleistung und Fachkenntnis, und kleine, lokal betriebene Modelle können den Datenschutz verbessern [11].
Stufe 1 nimmt S1-Inhalte auf und S2-Inhalte nur pseudonymisiert. Vor jedem Aufruf eines externen Modells erkennt eine lokale Komponente (etwa Presidio) Namen, Adressen, Telefonnummern, Kontoverbindungen und ähnliche Kennungen und ersetzt sie durch nummerierte Platzhalter [12]. Die Zuordnungstabelle zwischen Platzhalter und Originalwert entsteht je Anfrage und bleibt lokal; die Antwort des Modells wird vor der Anzeige lokal zurückübersetzt. Scheitert die Pseudonymisierung, etwa weil die Erkennungskomponente nicht erreichbar ist, sendet das System nichts und beantwortet die Anfrage lokal.
Die Pseudonymisierung senkt das Risiko, beseitigt es aber nicht. Der Europäische Datenschutzausschuss stellt in seinen Leitlinien klar, dass pseudonymisierte Daten personenbezogene Daten bleiben, dass die Zusatzinformationen, mit denen sich Pseudonyme auflösen lassen, getrennt und geschützt aufzubewahren sind, und dass Pseudonymisierung für sich genommen in der Regel nicht ausreicht [2]. Das Konzept zieht daraus die Konsequenz, S3 auch in pseudonymisierter Form nicht an externe Modelle zu geben. Bei vertraulichen Unterlagen bleibt das Risiko zu hoch, dass Personen aus dem Zusammenhang wiedererkennbar sind.
Stufe 2 nimmt S1-Inhalte auf und S2-Inhalte ebenfalls nur pseudonymisiert. Spitzenmodelle übertreffen lokale Modelle beim mehrstufigen Schlussfolgern und bei langen Texten deutlich; sie eignen sich deshalb für öffentliche Recherche, Strukturvorschläge und die Arbeit mit veröffentlichtem Fachwissen. Der Europäische Datenschutzausschuss weist darauf hin, dass Modelle, die mit personenbezogenen Daten trainiert wurden, nicht in jedem Fall als anonym gelten. Anonym ist ein Modell nur, wenn sich Trainingsdaten weder direkt aus ihm gewinnen noch durch Abfragen herauslocken lassen, und das ist im Einzelfall zu prüfen [13]. Umso wichtiger ist, dass nur öffentliche oder wirksam pseudonymisierte Inhalte diese Stufe erreichen.
Das Gateway (etwa LiteLLM) setzt diese Regeln bei jedem Aufruf durch. Die Schutzklasse ist dabei ein hartes Kriterium, das kein anderes Kriterium überstimmen kann. Innerhalb der zulässigen Stufen entscheidet der Aufgabentyp: Einstufung und Einbettung laufen immer lokal, Zusammenfassungen bevorzugt auf Stufe 1, mehrstufiges Schlussfolgern auf Stufe 2. Ist das Budget einer Stufe ausgeschöpft oder fällt ein Anbieter aus, weicht das Gateway auf die nächstniedrigere Stufe aus, nie auf eine höhere. Für Fachagenten gilt zusätzlich die Obergrenze aus ihrem Steckbrief; maßgeblich ist der niedrigere der beiden Werte. Jeder Aufruf wird mit Modell, Stufe und Kosten protokolliert, und jeder Fachagent erhält einen eigenen Zugangsschlüssel mit Budget.
Die Regeln liegen als Konfigurationsdatei vor, die Erfassung, Portal und Fachagenten gemeinsam lesen. Eine Änderung wirkt damit an allen Stellen zugleich, und eine Testsuite weist nach jeder Änderung nach, dass S3 die eigene Infrastruktur nicht verlässt. Das Konzept formuliert den Grundsatz dahinter ausdrücklich: Sicherheit entsteht aus Konfiguration und Programmcode, nicht aus Anweisungen an ein Sprachmodell.
5. Erfassung: Aus Eingängen wird geprüftes Wissen
Das Second Brain nimmt Inhalte über mehrere Wege auf. Dateien gelangen per Upload im Portal oder über einen Eingangsordner in den Bestand. Weblinks ruft ein Abrufdienst ab, der Anfragen in das eigene interne Netz unterbindet; Fundstücke aus der Websuche übernimmt das System nur nach Bestätigung. Sprachnotizen und Diktate transkribiert eine lokale Spracherkennung, weil sie häufig vertrauliche Inhalte tragen; Cloud-Dienste für Spracherkennung schließt das Konzept aus. Bilder erhalten eine Texterkennung und eine lokale Bildbeschreibung, eine Gesichtserkennung findet nicht statt. Aus sozialen Netzwerken übernimmt das System nur eigene Datenexporte und bewusst gespeicherte Beiträge, keine automatisiert ausgelesenen Seiten. Postfächer und Kalender liest ein Abrufdienst ausschließlich lesend.
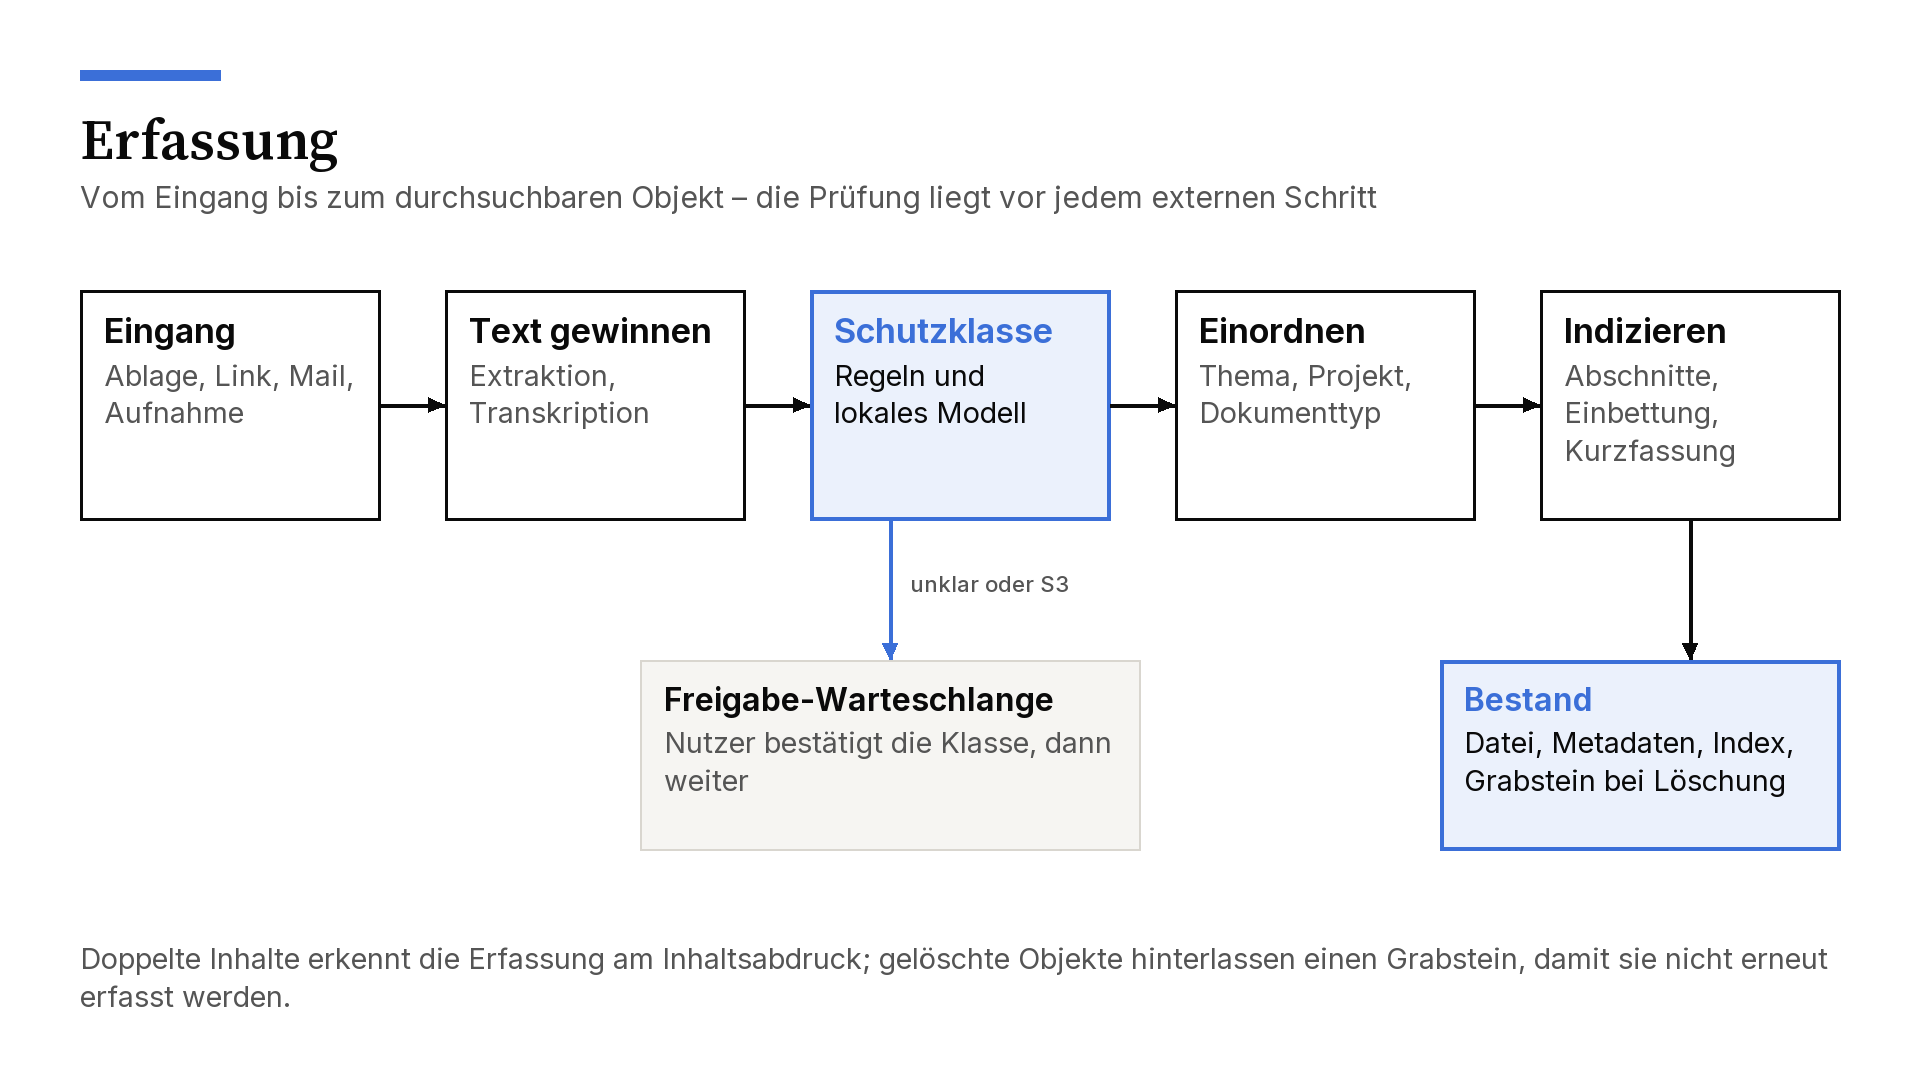
Ein Erfassungsdienst verarbeitet jedes Objekt in einer festen Reihenfolge, die Abbildung 3 zeigt. Zunächst gewinnt er den Text: Aus PDF- und Office-Dateien extrahiert eine lokale Komponente (etwa Docling) Text und Struktur einschließlich Texterkennung, aus Audio und Video entsteht ein Transkript mit Zeitmarken. Anschließend folgt die Einstufung nach Abschnitt 3. Erst danach ordnet der Dienst das Objekt ein. Er vergibt Themen aus einem festen Vokabular, im Referenzaufbau 22 Themen mit 69 Unterthemen und höchstens drei Themen je Objekt, sowie Projekt, Dokumenttyp und Dokumentdatum [14]. Auch hier arbeiten zuerst Regeln und dann ein lokales Modell. Entscheidend ist die Position der Einstufung: Sie liegt vor jedem Schritt, der ein externes Modell einbeziehen könnte.
Zuletzt zerlegt der Dienst den Text in Abschnitte von rund 1.200 Zeichen mit Überlappung, berechnet für jeden Abschnitt lokal einen Einbettungsvektor und legt beides in einer Vektordatenbank (etwa Qdrant) ab. Die Suche kombiniert semantische Ähnlichkeit mit lexikalischer Übereinstimmung und filtert nach Schutzklasse, Thema, Quelle und Datum. Eine relationale Datenbank führt das Objektverzeichnis mit Verarbeitungsstatus und Prüfsummen, und ein zweiter Index enthält Titel und Kurzfassung jedes Objekts. Der Bestand bietet damit zwei Zugänge: den Abschnittsindex für Fragen zum Inhalt und das Objektverzeichnis für Fragen über den Bestand selbst. Neue Objekte gelangen ausschließlich über den Erfassungsdienst in den Bestand.
Zwei Mechanismen halten den Bestand sauber. Die Kennung eines Objekts ist der kryptografische Hashwert seines Inhalts; eine identische Datei wird deshalb erkannt und nicht erneut erfasst. Gelöschte Objekte hinterlassen einen Grabstein, also einen Protokolleintrag ohne Inhalt, der eine erneute Erfassung verhindert. Das ist vor allem bei E-Mails wichtig, die ein Abrufdienst regelmäßig aus den Postfächern liest und zusätzlich über ihre Nachrichtenkennung gegen Bestand und Grabsteine abgleicht.
Für E-Mails gelten eigene Regeln. Der Abruf verschiebt, markiert und löscht nichts im Postfach, und der Bestand verweist auf das Original. Junk- und Papierkorbordner liest der Abrufdienst nicht. Newsletter und automatische Benachrichtigungen erkennt das System an ihren Kopfzeilen, stuft sie als S1 ein und löscht sie nach einer festen Frist von 90 beziehungsweise 30 Tagen. Alle übrigen Mails bleiben S3. Anhänge werden als eigene Objekte mit Verweis auf ihre Mail erfasst, und ein Personenverzeichnis macht Fragen nach Absendern, Zeiträumen und Gesprächsverläufen möglich.
Externe Wissensquellen bindet das Konzept föderiert an. Konnektoren für Dokumentenarchive oder Dateiablagen liefern eine einheitliche Antwort aus Treffer, Ausschnitt, Kennung und Schutzklasse, wahlweise live, über einen eigenen Index oder in einer Mischform. Ein Quellenregister legt je Quelle die zulässige Klasse und den Zugangsweg fest; ohne abweichende Festlegung erben externe Quellen die Klasse S3. Treffer aus einer S3-Quelle erhöhen die Klasse der gesamten Verarbeitung wie jedes andere S3-Objekt.
6. Antworten aus dem eigenen Bestand
Eine Frage durchläuft mehrere Schritte, die Abbildung 4 zeigt. Zuerst ordnet ein lokales Modell sie ein: Es bestimmt, ob es sich um eine Frage, eine zu speichernde Notiz oder einen Auftrag handelt, welcher Aufgabentyp vorliegt und welche Schutzklasse der Text der Frage hat. Danach ordnet das System die Frage einem Fachagenten zu, zuerst über Schlüsselbegriffe, dann über das lokale Modell. Die Suche im Bestand läuft mit dem Wissensfilter dieses Agenten, den die Datenbank selbst durchsetzt und den der Agent nicht verändern kann. Eine Nachsortierung bringt die Treffer in eine Rangfolge, und Treffer unterhalb eines Schwellwerts werden verworfen. Aus der Klasse der Frage und den Klassen der Treffer ergibt sich die zulässige Modellstufe; erst dann erzeugt ein Modell die Antwort.
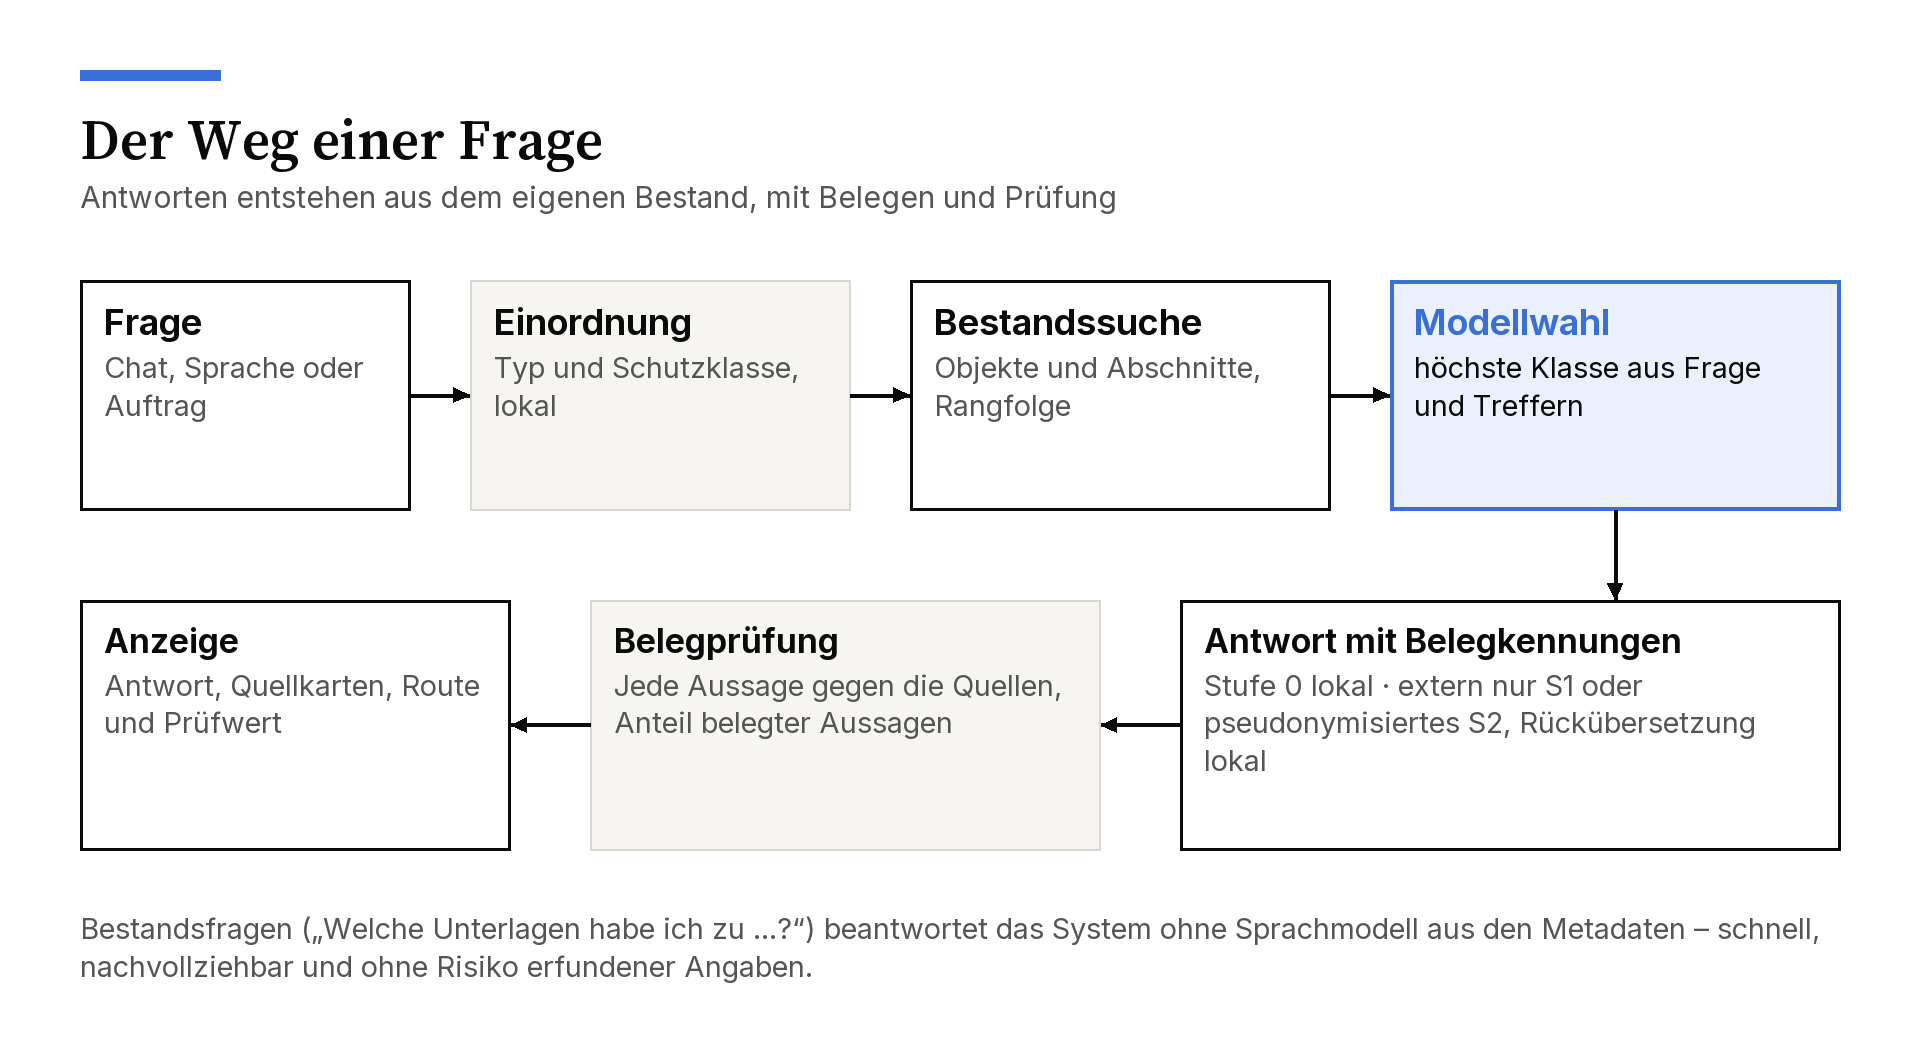
Dieses Vorgehen folgt dem Prinzip der retrieval-gestützten Generierung: Das Modell antwortet nicht aus seinem Trainingswissen, sondern aus den Textstellen, die ihm die Suche mitgibt [5]. Ein Antwortvertrag verpflichtet es, jede Tatsachenaussage mit der Kennung ihrer Quelle zu versehen. Aussagen ohne Beleg werden als nicht belegt gekennzeichnet oder entfallen, und ohne ausreichende Treffer lautet die Antwort, dass der Bestand keine Grundlage enthält. Das Konzept wertet diese Enthaltung ausdrücklich als erwünschtes Ergebnis.
Belege allein garantieren noch keine korrekte Antwort. Sprachmodelle erzeugen gelegentlich Aussagen, die plausibel klingen, aber nicht zutreffen, und auch retrieval-gestützte Systeme sind davor nicht geschützt, wenn die Suche unpassende Stellen liefert oder das Modell passende Stellen falsch verarbeitet [15]. Im Arbeitsalltag verschärft sich das Problem, weil Ergebnisse oft ungeprüft übernommen werden: In der erwähnten weltweiten Befragung gaben 66 % an, sich auf KI-Ergebnisse verlassen zu haben, ohne sie zu prüfen, und 56 %, deshalb Fehler gemacht zu haben [10]. Das Konzept prüft deshalb jede Antwort nach. Eine Belegprüfung zerlegt die Antwort in Einzelaussagen und prüft jede gegen die angegebene Quelle; ob eine Belegkennung überhaupt existiert, prüft der Programmcode und nicht das Modell. Der Anteil belegter Aussagen entspricht der Belegtreue (Faithfulness), wie sie Evaluationsverfahren für retrieval-gestützte Systeme definieren [6]. Bei S3 läuft auch diese Prüfung lokal. Die Oberfläche zeigt den Prüfwert zusammen mit den Quellen, getrennt nach Bestand, föderierten Quellen und Webquellen mit Abrufdatum, sowie die gewählte Route. Der Nutzer erkennt damit, worauf eine Antwort beruht und welches Modell sie erzeugt hat. Das Konzept fasst den Anspruch nüchtern: Erfundene Angaben lassen sich nicht ausschließen, aber messbar, sichtbar und korrigierbar machen. Warum die ungeprüfte Übernahme von KI-Ergebnissen über den einzelnen Fehler hinaus die eigene Urteilskraft schwächen kann, hat der Verfasser in Kognitiver Offload dargelegt.
Ein Teil der Fragen braucht überhaupt kein Sprachmodell. Fragen über den Bestand, etwa welche Unterlagen zu einem Projekt vorliegen, welche Mails ein Absender im Juli geschickt hat oder was zuletzt erfasst wurde, beantwortet das System deterministisch aus dem Objektverzeichnis. Solche Antworten liegen in Sekundenbruchteilen vor, sind vollständig nachvollziehbar und können keine Angaben erfinden. Nur die Zusammenfassung eines Gesprächsverlaufs ruft auf ausdrücklichen Wunsch ein Sprachmodell auf, wegen der Daten Dritter stets auf Stufe 0.
Ein System, das fremde Dokumente liest, muss zudem mit eingeschleusten Anweisungen rechnen. Angreifer können solche Anweisungen gezielt in Webseiten, Dokumente oder E-Mails einbetten, die ein System voraussichtlich abruft [16]. OWASP führt die Einschleusung von Anweisungen (Prompt Injection) als erstes Risiko für Anwendungen mit Sprachmodellen, hält es für unklar, ob es ein lückenloses Verfahren zu ihrer Verhinderung gibt, und empfiehlt unter anderem minimale Rechte, eine menschliche Freigabe riskanter Aktionen und die Kennzeichnung externer Inhalte [17]. Das Second Brain setzt diese Maßnahmen um. Alle erfassten Inhalte gelten als nicht vertrauenswürdige Daten und nie als Anweisung; Quellen und Ergebnisse anderer Agenten erreichen das Modell als gekennzeichnete Datenblöcke, und Webinhalte verändern niemals Verfahrensbeschreibungen oder Gedächtnis des Systems. Für Vektordatenbanken nennt OWASP außerdem den Abfluss von Daten zwischen Kontexten als eigenes Risiko und empfiehlt eine berechtigungsabhängige Zugriffskontrolle [17]; der Wissensfilter, den die Datenbank selbst durchsetzt, entspricht dieser Empfehlung. Präparierte Testdokumente prüfen regelmäßig, ob das System eingeschleuste Anweisungen ignoriert, und ein Beobachtungswerkzeug (etwa Langfuse) hält zu jeder Antwort Suche, Eingabe, Modell, Stufe, Prüfergebnis und Kosten fest.
7. Fachkollegium: spezialisierte Agenten mit Mandat
Fragen und Antworten decken nur einen Teil der Wissensarbeit ab. Für fachliche Prüfung und Beratung kennt das Konzept ein Fachkollegium aus spezialisierten Fachagenten. Ein Fachagent besteht aus vier Teilen, die Abbildung 5 zeigt: einem Steckbrief, einer Verfahrensbeschreibung, einer Wissensbasis und einem Evaluationsset. Die Wissensbasis hat drei Schichten: den Ausschnitt des Bestands, den der Wissensfilter freigibt, einen kuratierten Fachkorpus aus öffentlichen Quellen und Lernnotizen, die nur ergänzt, nie überschrieben werden und ihre Herkunft ausweisen.
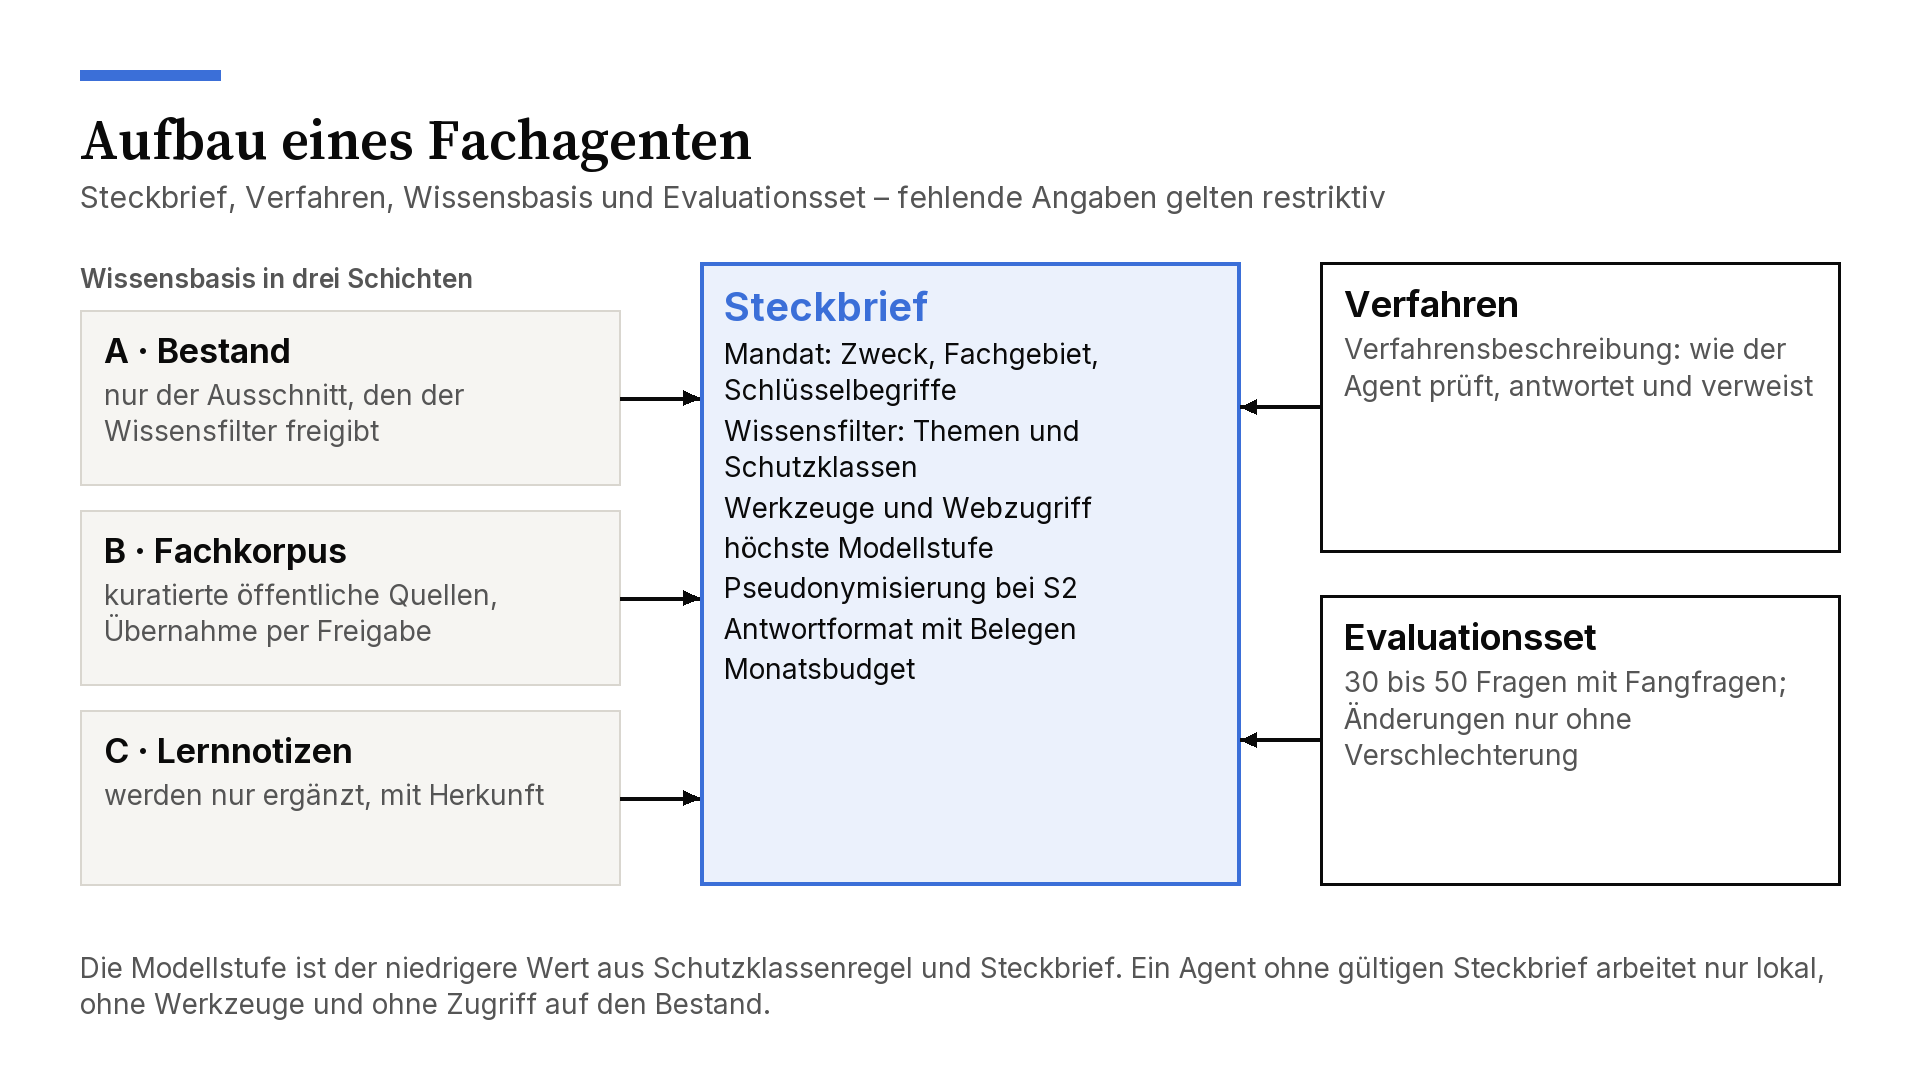
Der Steckbrief legt fest, wofür ein Agent zuständig ist und was er darf. Er beschreibt Zweck, Fachgebiet und Schlüsselbegriffe, den Wissensfilter nach Themen und Schutzklassen, die zulässigen Werkzeuge, den Webzugriff, die höchste Modellstufe, die Pflicht zur Pseudonymisierung bei S2, das Antwortformat, die Belegprüfung, das Evaluationsset und ein Monatsbudget. Fehlende Angaben gelten restriktiv. Im Referenzaufbau umfasst das Kollegium 25 Steckbriefe, darunter Fachagenten für Datenschutz, Informationssicherheit, Notfallmanagement, IT-Servicemanagement, Projektmanagement, Wirtschaftlichkeit, Recht, Gesundheit, Nachhaltigkeit, KI-Strategie und Kommunikation sowie einen Generalisten und einen Kritiker [14].
Die Zusammenarbeit steuert ein Dirigent. Er ist Programmcode und kein Sprachmodell, damit die Steuerung deterministisch und prüfbar bleibt. Der Dirigent zieht je Lauf höchstens drei Agenten heran: im Einzelmodus einen Fachagenten, im Duett zwei, im Kollegium mehrere einschließlich eines Kritikers. Agenten rufen nur Werkzeuge auf und nie andere Agenten; ihre Ergebnisse erreichen den Dirigenten als Datenblöcke. Der Kritiker hat keinen Zugriff auf den Bestand und arbeitet ausschließlich mit den Beiträgen der Fachagenten, die er auf unbelegte Annahmen, Widersprüche und Lücken prüft. Die zusammengeführte Antwort entsteht nie auf einer höheren Modellstufe, als die höchste beteiligte Klasse erlaubt. Dass der Nutzen von KI-Agenten aus Gedächtnisarchitektur und Systemdesign entsteht und weniger aus der Formulierung einzelner Anweisungen, hat der Verfasser in Die wahren Regeln für KI-Agenten ausgeführt.
Fragen außerhalb seines Wissensfilters beantwortet ein Agent nicht inhaltlich, sondern mit einem Verweis auf den zuständigen Kollegen. Ein solcher Mandatsverweis ist nie die Endantwort: Der Dirigent leitet die Frage an den zuständigen Agenten weiter, ersatzweise an den Generalisten oder den Bestandsweg, innerhalb eines festen Budgets von sechs Agentenläufen oder 240 Sekunden.
Den Fachkorpus pflegt ein wöchentlicher Kuratierungslauf. Er durchsucht festgelegte Primärquellen nach neuen Dokumenten und legt sie dem Nutzer als Vorschläge vor. Die Suchbegriffe stammen ausschließlich aus dem Steckbrief und nie aus Inhalten des Bestands; auf diesem Weg gelangt keine vertrauliche Information in eine Suchanfrage. Übernommene Dokumente durchlaufen eine Quarantäne, bevor sie im Korpus wirken, und eine automatische Übernahme ist abgeschaltet.
Auch das Kollegium selbst entwickelt sich unter Kontrolle weiter. Häufen sich verwandte Anfragen ohne zuständigen Agenten, schlägt das System einen neuen Fachagenten vor, der erst nach Freigabe aktiv wird; Agenten ohne Nutzung ruhen nach 90 Tagen. Änderungen an einer Verfahrensbeschreibung prüft ein Vergleich zwischen bisheriger und neuer Fassung auf dem Evaluationsset. Übernommen wird eine Änderung nur, wenn keine Kennzahl sinkt und mindestens eine steigt.
8. Werkstatt und Wissensräume: vom Wissen zum Ergebnis
Häufiger als eine einzelne Antwort braucht Wissensarbeit ein Ergebnis, etwa einen Bericht, eine Stellungnahme oder eine Präsentation. Dafür kennt das Konzept eine Werkstatt. Ein Werkstück ist ein Ordner im Bestand mit fortlaufend nummerierten Fassungen, einer Beschreibung von Ziel und Schutzklasse und einem Beschlussprotokoll, das nur ergänzt wird. Jeder Absatz trägt einen Herkunftsvermerk. Fachagenten schreiben nie direkt in ein Werkstück; sie liefern Beiträge, über die der Nutzer entscheidet.
Die Werkstatt folgt dem Grundsatz „Ergebnis zuerst“, den Abbildung 6 zeigt. Der Nutzer beschreibt in einem Auftragsdialog Ziel, Ergebnisart, Umfang und Zielgruppe. Ein Ergebnislauf durchläuft danach sechs Phasen: Zuordnung der Fachagenten, Gliederung, Fachbeiträge je Abschnitt, Kritik, Produktion und Dateierzeugung. Das Ergebnis ist eine vollständige Fassung mit vorangestellter Zusammenfassung und einer Qualitätsampel. Die Befunde der Fachagenten gelten als eingearbeitet; verwirft der Nutzer einen Befund, entsteht eine gezielte Neufassung, und die Vorfassung bleibt erhalten. Das Konzept setzt als Ziel höchstens fünf Interaktionen vom Auftrag bis zur fertigen Datei; frühere, schrittweise Abläufe benötigten 35 bis 50.
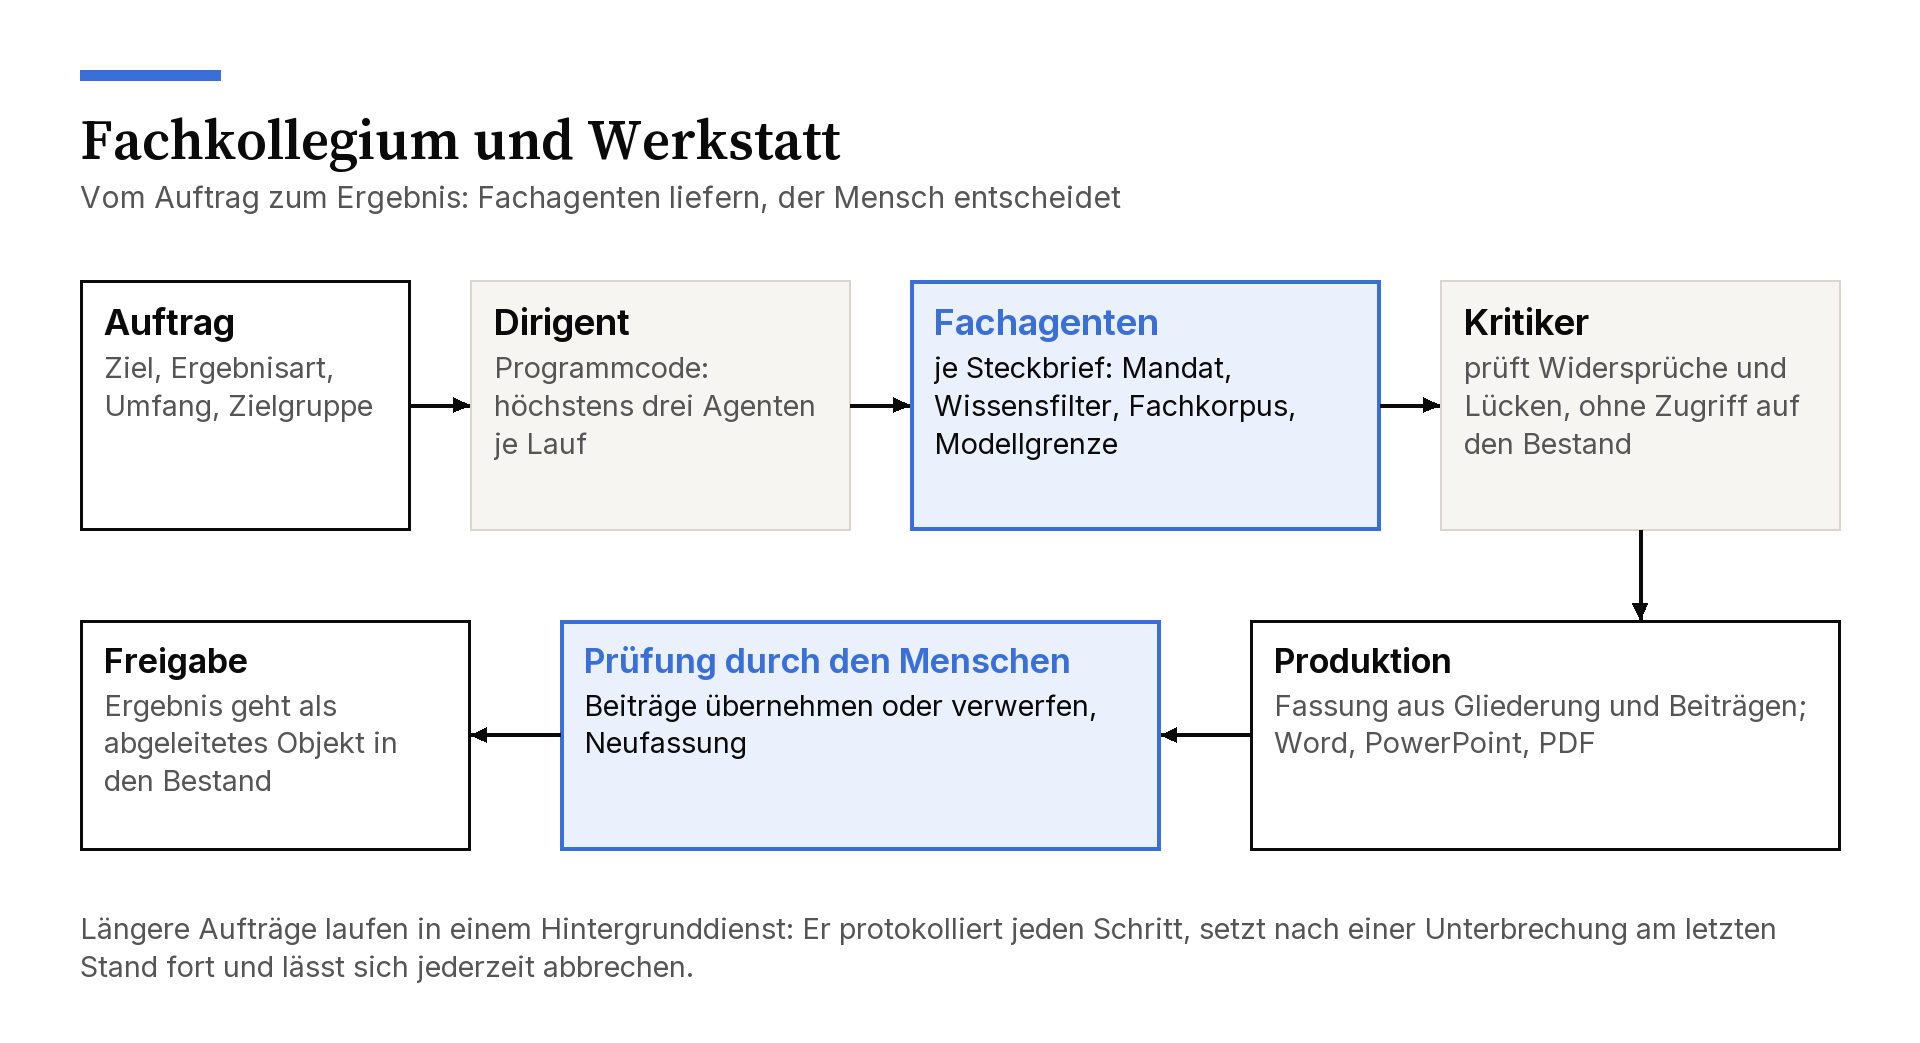
Die Dateien entstehen deterministisch. Das Sprachmodell liefert nur Inhalt und Folienplan; ein Werkzeug ohne Internetzugang erzeugt daraus Word-, PowerPoint- und PDF-Dateien. Die Schutzklassenregel gilt damit auch für die Dateierzeugung. Ein Werkstück erhält seine Klasse beim Anlegen über drei Fragen: ob es Daten Dritter enthält, ob es aus geschäftlichen Unterlagen stammt und ob besondere Kategorien personenbezogener Daten betroffen sind. Die Klasse kann später steigen, aber nicht sinken, und bestimmt die Modellstufe aller Beteiligten. Ein vertrauliches Werkstück entsteht damit vollständig auf Stufe 0, einschließlich Gliederung, Fachbeiträgen, Kritik und Produktion.
Längere Aufträge laufen in einem eigenen Hintergrunddienst. Er arbeitet die Aufträge aus einer Warteschlange ab, protokolliert jeden Schritt, setzt nach einem Neustart am letzten gesicherten Stand fort und lässt sich jederzeit abbrechen. Aus einem Chat entsteht ein Werkstück ohne weiteren Modellaufruf: Eine Auftragskarte übernimmt Frage und Kontext, und der Klick des Nutzers bestätigt zugleich die Schutzklasse.
Wissensräume bündeln den Bestand zu einem Thema. Ein Raum umfasst ein Quellenverzeichnis, die Kurzfassungen der Objekte und ein Raum-Dossier mit Fundstellen, das nachts auf Stufe 0 entsteht. Das Dossier liegt in drei Fassungen vor: aus S1-Quellen, aus S1- und S2-Quellen und aus allen Klassen. Läufe auf Stufe 1 oder 2 erhalten ausschließlich die S1-Fassung, und ein Leck-Test prüft, dass sie nichts aus höheren Klassen enthält.
Freigegebene Ergebnisse gehen als abgeleitete Objekte in den Bestand zurück. Entwürfe werden nicht indexiert. Freigegebene Fassungen tragen einen Herkunftsvermerk mit den Quellen, aus denen sie entstanden sind, und zählen bei späteren Antworten nicht als unabhängige Bestätigung dieser Quellen. Ein Produktionsauftrag arbeitet zudem mit einem eingefrorenen Übergabepaket aus Kennungen und Ständen; der produzierende Agent kann sein eigenes Ergebnis nicht freigeben.
9. Kontrolle und Nachweis
Regeln schützen nur, wenn ihre Einhaltung nachgewiesen wird. Art. 32 der Datenschutz-Grundverordnung verlangt neben Pseudonymisierung und Verschlüsselung ein Verfahren zur regelmäßigen Überprüfung der Wirksamkeit der technischen und organisatorischen Maßnahmen [1]. Das Konzept verbindet deshalb mehrere Prüfmechanismen zu einem Kreislauf, den Abbildung 7 zeigt.
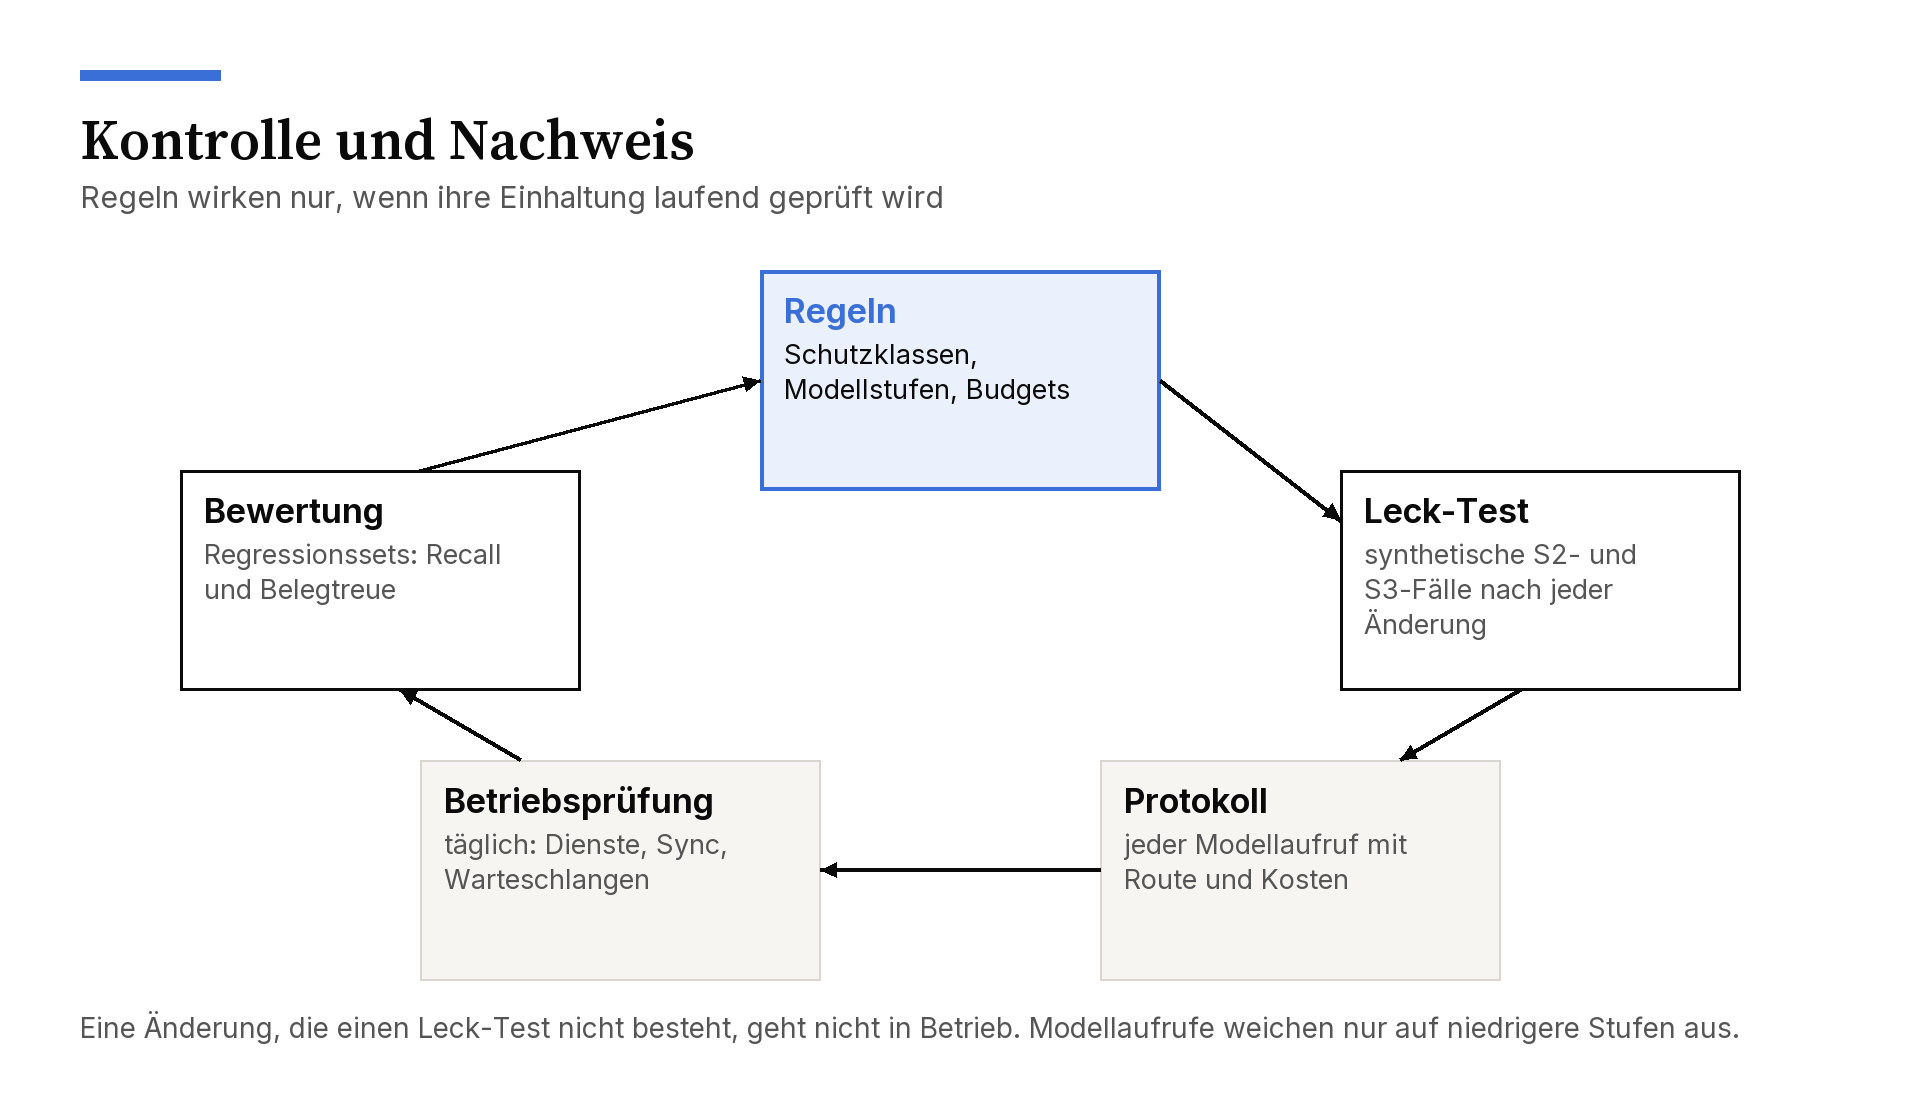
Leck-Tests prüfen die Regeln mit synthetischen Fällen, die keine echten Daten enthalten. Eine Testsuite weist nach jeder Änderung der Konfiguration nach, dass S3 die eigene Infrastruktur nicht verlässt. Ein Kollegiumslauf mit einem präparierten S3-Dokument darf keinen Klartext außerhalb lokaler Aufrufe erzeugen. Zwei synthetische S2-Dokumente mit erfundenen Personen, Firmen, Kontoverbindungen und Anschriften durchlaufen den echten Erfassungsweg, während ein Sensor jede ausgehende Anfrage an externe Modelle protokolliert; keine dieser Kennungen darf dort im Klartext erscheinen. Weitere Tests prüfen die Werkstatt, die Dossiers der Wissensräume und den gemieteten Grafikprozessor, auf dem nach einem Auftrag außer dem Modell nichts verbleiben darf. Eine Änderung, die einen Leck-Test nicht besteht, geht nicht in Betrieb.
Eine tägliche Betriebsprüfung wertet den Zustand des Systems aus. Sie prüft Abgleich und Sicherung, Staus im Eingang und in der Freigabe-Warteschlange, Erfassungsfehler, den Index, die Erreichbarkeit aller Dienste, die Budgets ab einer Auslastung von 80 % und die Laufzeit des Grafikprozessors. Ein Monatsbericht verdichtet Kosten je Schlüssel und Modell, Kennzahlen je Fachagent und die Nutzung des Grafikprozessors. Quartalsweise folgen ein Wiederherstellungstest der Sicherung, eine Versionsprüfung und eine Rückschau.
Die Qualität der Antworten misst das System mit Evaluationssets aus 30 bis 50 Fragen je Fachagent, darunter Fangfragen, auf die der Bestand keine Antwort enthält. Ein Regressionslauf folgt jeder Änderung an Verfahrensbeschreibung, Modell, Modellstufe oder Index. Für die Kennzahlen gelten feste Zielwerte:
| Kennzahl | Zielwert | Bedeutung |
|---|---|---|
| Kontext-Recall | ≥ 0,90 | Anteil der erwarteten Quellen, die die Suche findet |
| Belegtreue (Faithfulness) | ≥ 0,95 | Anteil der Aussagen, die die Quellen tragen |
| Antwortkorrektheit | ≥ 0,85 | fachliche Richtigkeit gegenüber einer Musterantwort |
| Enthaltung bei Fangfragen | ≥ 0,90 | Anteil korrekt verweigerter Antworten ohne Grundlage |
| Zitierpräzision | ≥ 0,90 | Anteil der Belege, die die Aussage tatsächlich stützen |
| Injektionsresistenz | 1,00 | kein präpariertes Testdokument verändert das Verhalten |
Belegtreue und Kontext-Recall lehnen sich an etablierte Evaluationsverfahren für retrieval-gestützte Systeme an [6] [18]. Unterschiede unter etwa zwei Prozentpunkten wertet das Konzept als nicht signifikant. Ergänzend prüft der Nutzer wöchentlich eine Stichprobe von zehn Antworten.
Das Löschkonzept schließt den Kreislauf. Eine Löschung entfernt Original, Textfassung, Metadaten, Indexeinträge und Datenbankzeile und hinterlässt nur den Grabstein. Löschen bleibt eine Handlung des Nutzers; automatisch löscht das System nur nach festen Aufbewahrungsregeln, etwa bei Newslettern. Sicherungen enthalten gelöschte Objekte bis zum Ablauf ihrer Aufbewahrungsfrist. Damit unterstützt das Konzept das Recht auf Löschung nach Art. 17 und setzt den Grundsatz der Speicherbegrenzung aus Art. 5 der Datenschutz-Grundverordnung technisch um [1]. Für die Steuerung gelten vier organisatorische Regeln: Änderungen nur über eine Versionsverwaltung, keine Handlung mit Außenwirkung ohne Bestätigung je Aktion, ein fortlaufendes Journal und eine Rückschau je Quartal.
10. Betrieb: Infrastruktur, Leistung und Kosten
Das Konzept kommt mit einem gemieteten Server in der Europäischen Union aus, im Referenzaufbau mit zwölf Prozessorkernen [14]. Alle Dienste laufen in Containern ohne besondere Rechte und mit schreibgeschütztem Dateisystem. Öffentlich erreichbar sind nur die Webzugänge über verschlüsselte Verbindungen, geschützt durch eine Anmeldung mit zweitem Faktor; die Administration läuft ausschließlich über ein virtuelles privates Netz. Zwei Netzzonen trennen Dienste ohne Internetbedarf, etwa Datenbanken und Index, von Diensten mit Internetzugang. Geheimnisse liegen verschlüsselt vor, die Versionen aller Programme und Modelle sind fest vorgegeben, und jede Änderung am Server läuft über die Versionsverwaltung. Die tägliche Sicherung ist verschlüsselt und nur anhängend beschreibbar; im Referenzaufbau stellte ein Wiederherstellungstest 40 von 40 Stichprobendateien byteidentisch wieder her [14].
Die Souveränität des Konzepts hängt an der Leistung von Stufe 0. Ein lokales Sprachmodell auf dem Server-Prozessor genügt für die Einstufung, die Einordnung und kurze Antworten, wird bei längeren Aufgaben aber zum Engpass. Im Referenzaufbau erzeugte ein kompaktes lokales Modell auf dem Prozessor 16 bis 23 Token pro Sekunde, auf einem gemieteten Grafikprozessor dagegen 100 bis 173 Token pro Sekunde. Eine vertrauliche Anfrage an das Kollegium dauerte auf dem Prozessor im Median 181 Sekunden, auf dem Grafikprozessor 10 Sekunden, also rund ein Achtzehntel [14]. Mehrere gleichzeitige Anfragen verlängern auf dem Prozessor die Gesamtdauer, statt sie zu verkürzen. Abbildung 8 stellt die Werte gegenüber.
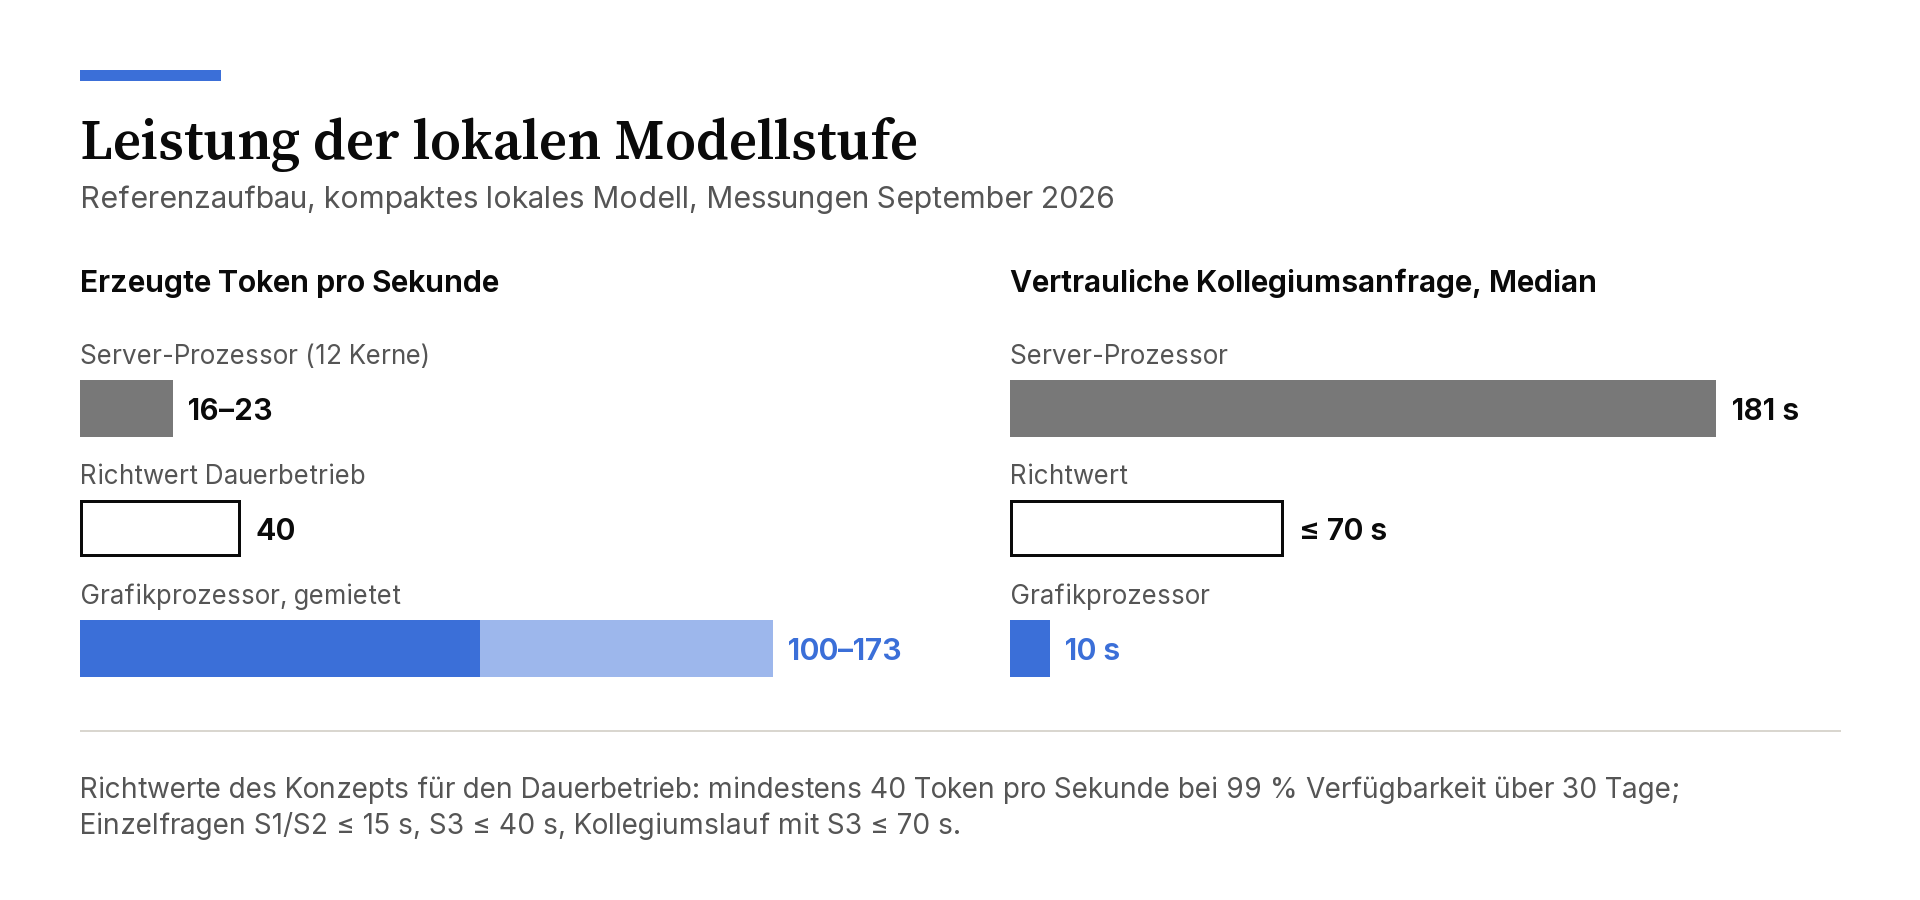
Für die Planung nennt das Konzept Richtwerte: Einzelfragen der Klassen S1 und S2 in höchstens 15 Sekunden, S3-Fragen in höchstens 40 Sekunden, Kollegiumsläufe mit S3 in höchstens 70 Sekunden. Als Schwelle für eine leistungsfähige lokale KI im Dauerbetrieb gelten mindestens 40 Token pro Sekunde bei einer Verfügbarkeit von 99 % über 30 Tage. Ein reiner Prozessorbetrieb erreicht diese Werte bei längeren Aufgaben nicht.
Drei Betriebsformen kommen in Betracht. Ein Grafikprozessor auf Abruf verursacht nur Kosten, solange er läuft, steht aber nicht immer sofort bereit: Anbieter garantieren keine Kapazität, und im Referenzaufbau dauerte jeder Start 36 bis 83 Sekunden [14]. Ein harter Stopp nach vier Stunden begrenzt dabei die Kosten hängender Aufträge. Ein fest gemieteter Server mit Grafikprozessor steht ständig bereit und kostet im Referenzaufbau rund 214 € netto im Monat. Eigene Hardware bietet die größte Kontrolle, verlangt aber Investition, Stromversorgung und Wartung. Gegenüber dem Abruf lohnt sich der fest gemietete Server im Referenzaufbau ab etwa 125 Betriebsstunden im Monat; ersetzt er zugleich den bisherigen Server, sinkt die Schwelle auf etwa 94 Stunden [14]. Die Wahl hängt damit von der gemessenen Nutzung ab, und der Monatsbericht liefert dafür Stunden, Kosten, abgelehnte Startanfragen und Wartezeiten.
Die Modellgröße ist die zweite Stellgröße. Kompakte Modelle mit wenigen Milliarden Parametern erreichen auch auf kleineren Grafikprozessoren hohe Geschwindigkeiten, liefern bei anspruchsvollen Analysen aber schwächere Ergebnisse als große Cloud-Modelle. Größere offene Modelle verringern diesen Abstand, benötigen aber Grafikprozessoren mit mehr Speicher. Die Evaluationssets aus Abschnitt 9 machen diese Abwägung messbar: Ein Modellwechsel geht erst in Betrieb, wenn die Zielwerte gehalten werden. Für den Gesamtbetrieb einschließlich externer Modelle sah die Planung 90 bis 170 € im Monat vor, davon ein Budget von 110 € für Modellaufrufe [14].
11. Bewertung: Optionen, Risiken, Gegenargumente
Wer Wissensarbeit mit KI unterstützen will, hat drei grundsätzliche Optionen. Sensible Inhalte lassen sich von KI ausschließen, was auf den größten Teil des Nutzens verzichtet. Cloud-Dienste lassen sich mit vertraglichen Zusagen nutzen, wobei das Restrisiko beim Nutzer bleibt. Oder die Verarbeitung wird, wie hier beschrieben, nach Schutzklassen getrennt. Nach Einschätzung des Verfassers verbindet nur die dritte Option einen hohen Nutzen mit einer nachweisbaren Einhaltung der Datenschutzgrundsätze, weil sie die Entscheidung über den Datenfluss in eine prüfbare Regel verlagert.
Das Konzept hat eigene Risiken. Die automatische Einstufung kann irren; restriktive Voreinstellungen und die Freigabe-Warteschlange begrenzen diesen Fehler, beseitigen ihn aber nicht. Die Pseudonymisierung erkennt nicht jede Kennung; auch die Entwickler der Erkennungskomponente weisen darauf hin, dass eine automatische Erkennung nicht alle sensiblen Daten garantiert findet [12]. Aus dem Zusammenhang kann eine Person zudem wiedererkennbar bleiben, und die ENISA empfiehlt deshalb, Pseudonymisierungstechniken nach dem Risiko des Einzelfalls auszuwählen [19]. Lokale Modelle bleiben bei komplexen Aufgaben hinter Spitzenmodellen zurück, sodass vertrauliche Analysen weniger gut ausfallen können als öffentliche. Sicherungen enthalten gelöschte Objekte bis zum Ablauf der Aufbewahrung. Der Betrieb schließlich verlangt Fachkenntnis, denn Grafikprozessor, Gateway, Index und Prüfungen müssen gepflegt werden, und bei einem Betrieb durch eine einzelne Person fehlt eine Vertretung.
Das stärkste Gegenargument lautet, dass große Anbieter inzwischen Rechenzentren in der Europäischen Union, Verträge zur Auftragsverarbeitung und Zusagen anbieten, Kundendaten nicht für das Training zu verwenden. Diese Zusagen verringern das Risiko erheblich und können für pseudonymisierte S2-Inhalte genügen. Für S3 bleibt jedoch die Abhängigkeit von Vertragstreue, von Zugriffsrechten Dritter und von der Rechtslage außerhalb der Europäischen Union; für besondere Kategorien gilt zudem das grundsätzliche Verarbeitungsverbot mit engen Ausnahmen [1]. Dass eine Datenresidenz in der Europäischen Union nicht vor dem Exportrecht der Vereinigten Staaten schützt, hat der Verfasser am Fall Fable in Verfügbarkeit ist keine Technik-Frage gezeigt. Ein zweites Gegenargument betrifft den Aufwand: Für kleine Bestände kann eine rein lokale Lösung ohne externe Stufen einfacher sein. Das Konzept lässt diese Vereinfachung zu, indem Stufe 1 und Stufe 2 abgeschaltet bleiben.
Regulatorisch ist neben dem Datenschutz die KI-Verordnung der Europäischen Union zu beachten. Sie gilt nicht für natürliche Personen, die KI ausschließlich für persönliche und nicht berufliche Zwecke nutzen; ein Second Brain im Unternehmen fällt dagegen in ihren Anwendungsbereich [20]. Seit dem 2. Februar 2025 gelten die Verbote bestimmter Praktiken und die Pflicht, für ausreichende KI-Kompetenz der Beschäftigten zu sorgen [20]. Die Anforderungen an Hochrisiko-Systeme nach Anhang III greifen nach einer Änderung der Verordnung ab dem 2. Dezember 2027 [21]. Den Kommissionsvorschlag, auf den diese Änderung zurückgeht, hat der Verfasser in Wie Brüssel den AI Act praxistauglicher macht eingeordnet. Ein Wissenssystem für Recherche und Textproduktion gehört nicht zu diesen Hochrisiko-Bereichen, solange es nicht etwa für Personalentscheidungen oder Kreditwürdigkeitsprüfungen eingesetzt wird. Protokollierung und Belegprüfung erleichtern dennoch den Nachweis eines kontrollierten Einsatzes.
Der Beitrag beschreibt das Konzept in seiner vorgesehenen Zielform und stützt Leistungs- und Kostenangaben auf einen Referenzaufbau. Diese Werte lassen sich nicht ohne Weiteres übertragen, denn Geschwindigkeit und Kosten hängen von Modell, Hardware und Nutzung ab. Rechtliche Aussagen geben den Stand der zitierten Quellen wieder und ersetzen keine Beratung im Einzelfall.
12. Handlungscheckliste
- Bestand erheben: Quellen, Formate und Mengen erfassen, bevor Werkzeuge ausgewählt werden; dabei festhalten, welche Inhalte Daten Dritter enthalten.
- Schutzklassen festlegen: Definitionen, Beispiele und die Regel „im Zweifel S3“ schriftlich fixieren und mit den Beteiligten abstimmen.
- Routing zentralisieren: Alle Modellaufrufe über ein Gateway führen, das die höchste beteiligte Klasse durchsetzt, nur nach unten ausweicht und jeden Aufruf protokolliert.
- Lokale Modellstufe dimensionieren: Nutzung messen, Richtwerte für Geschwindigkeit und Verfügbarkeit festlegen und Abruf, Festmiete und eigene Hardware vergleichen.
- Pseudonymisierung prüfen: Erkennungsrate mit synthetischen Beispielen messen, die Zuordnungstabelle lokal halten und bei einem Ausfall lokal statt unmaskiert verarbeiten.
- Antworten belegen lassen: Antwortvertrag mit Quellkennungen und automatische Belegprüfung einführen, Zielwerte für Recall und Belegtreue setzen.
- Nachweis automatisieren: Leck-Tests nach jeder Änderung, tägliche Betriebsprüfung und monatlichen Bericht einrichten.
- Verträge schließen: Auftragsverarbeitungsverträge mit allen Anbietern von Rechenleistung, Speicher und Modellen abschließen und im Verzeichnis der Verarbeitungstätigkeiten dokumentieren.
- Löschkonzept umsetzen: Aufbewahrungsfristen je Inhaltsart festlegen und Löschungen mit Grabstein protokollieren.
Quellen
- Europäisches Parlament und Rat der Europäischen Union: Verordnung (EU) 2016/679 (Datenschutz-Grundverordnung). Amtsblatt der EU L 119 vom 4. Mai 2016, S. 1; herangezogen insbesondere Art. 2, 4, 5, 9, 17, 25, 28, 32 und 83. eur-lex.europa.eu (Abruf: 25.09.2026).
- Europäischer Datenschutzausschuss (EDPB): Guidelines 01/2025 on Pseudonymisation. Fassung zur öffentlichen Konsultation, angenommen am 16. Januar 2025. edpb.europa.eu (Abruf: 25.09.2026).
- Maddison, Lewis: Samsung workers made a major error by using ChatGPT. TechRadar, 4. April 2023. techradar.com (Abruf: 25.09.2026).
- Cyberhaven Labs: 2026 AI Adoption & Risk Report. Cyberhaven, Februar 2026 (Telemetriedaten des Anbieters, nicht begutachtet). cyberhaven.com (Abruf: 25.09.2026).
- Lewis, Patrick et al.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems 33 (NeurIPS 2020), 2020. arxiv.org (Abruf: 25.09.2026).
- Es, Shahul; James, Jithin; Espinosa-Anke, Luis; Schockaert, Steven: RAGAs: Automated Evaluation of Retrieval Augmented Generation. Proceedings of EACL 2024: System Demonstrations, S. 150–158, 2024. aclanthology.org (Abruf: 25.09.2026).
- Forte, Tiago: Building a Second Brain: The Definitive Introductory Guide. Forte Labs, Mai 2023, aktualisiert November 2023. fortelabs.com (Abruf: 25.09.2026).
- Forte, Tiago: Building a Second Brain: A Proven Method to Organize Your Digital Life and Unlock Your Creative Potential. Simon & Schuster (Simon Element), 2022. simonandschuster.com (Abruf: 25.09.2026).
- Park, Kate: Samsung bans use of generative AI tools like ChatGPT after April internal data leak. TechCrunch, 2. Mai 2023. techcrunch.com (Abruf: 25.09.2026).
- Gillespie, Nicole; Lockey, Steve; Ward, Tabi; Macdade, Alexandria; Hassed, Gerard: Trust, attitudes and use of artificial intelligence: A global study 2025. The University of Melbourne und KPMG, April 2025. doi.org (Abruf: 25.09.2026).
- Barberá, Isabel (EDPB Support Pool of Experts): AI Privacy Risks & Mitigations – Large Language Models (LLMs). Europäischer Datenschutzausschuss, April 2025. edpb.europa.eu (Abruf: 25.09.2026).
- Data Privacy Stack (ursprünglich Microsoft): Presidio – Data Protection and De-identification SDK. GitHub, o. J., MIT-Lizenz. github.com (Abruf: 25.09.2026).
- Europäischer Datenschutzausschuss (EDPB): Opinion 28/2024 on certain data protection aspects related to the processing of personal data in the context of AI models. Angenommen am 17. Dezember 2024. edpb.europa.eu (Abruf: 25.09.2026).
- Dunkel, Olaf: Eigene Messungen und Auszählungen im Referenzaufbau des Second Brain. Stand 25. September 2026, unveröffentlicht.
- Huang, Lei et al.: A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions. ACM Transactions on Information Systems 43 (2), Art. 42, 2025. dl.acm.org (Abruf: 25.09.2026).
- Greshake, Kai et al.: Not What You've Signed Up For: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection. AISec ’23, ACM, 2023, S. 79–90. arxiv.org (Abruf: 25.09.2026).
- OWASP Gen AI Security Project: OWASP Top 10 for LLM Applications 2025 (LLM01 Prompt Injection, LLM08 Vector and Embedding Weaknesses). OWASP Foundation, November 2024. genai.owasp.org (Abruf: 25.09.2026).
- Ragas: Context Recall. Dokumentation der Evaluationsbibliothek Ragas, o. J. docs.ragas.io (Abruf: 25.09.2026).
- ENISA – Agentur der Europäischen Union für Cybersicherheit (Bourka, A.; Drogkaris, P.; Agrafiotis, I., Hrsg.): Pseudonymisation techniques and best practices. ENISA, November 2019. enisa.europa.eu (Abruf: 25.09.2026).
- Europäisches Parlament und Rat der Europäischen Union: Verordnung (EU) 2024/1689 (KI-Verordnung). Amtsblatt der EU L vom 12. Juli 2024; herangezogen insbesondere Art. 2, 4 und 113. eur-lex.europa.eu (Abruf: 25.09.2026).
- Europäisches Parlament und Rat der Europäischen Union: Verordnung (EU) 2026/1744 (Digital Omnibus on AI). Änderung der Verordnung (EU) 2024/1689, Amtsblatt der EU L vom 24. Juli 2026. eur-lex.europa.eu (Abruf: 25.09.2026).
🎧 Diesen Beitrag als Podcast hören
Die Kernthesen dieses Artikels gibt es auch als Podcast-Episode: DSGVO-sicheres KI-Zweitgehirn für Unternehmen (27:12 Min.)
Weiterlesen im Themenfeld
- Verfügbarkeit ist keine Technik-Frage: Die Fable-Lehre für Europas Souveränität
- Architektur schlägt Hype: Warum hekima.one auf Minimalismus und lokale Daten setzt
- Datenzentrierte Verschlüsselung: Schlüssel zum Glück oder zum Daten-GAU?
- Digitale Souveränität in Europa
- Die wahren Regeln für KI-Agenten, die heute schon Werte schaffen
Analysen wie diese in den Posteingang?
Jeden Mittwoch die KI-News der Woche: Digital Health, KI-Governance, digitale Souveränität, Public Sector und KI-Agenten. Kein Spam, jederzeit abbestellbar.
Newsletter abonnieren